Intelligent Document Processing Market (2026 – 2035)

구성 요소별(솔루션, 서비스), 배포 모드별(온프레미스, 클라우드), 조직 규모별(중소기업, 대기업), 기술별(NLP, OCR, RPA, 컴퓨터 비전, 딥러닝(DL), 머신러닝(ML)), 수직별(BFSI, 정부 및 국방, 소매 및 전자상거래, 제조, 의료 및 생명 과학, 운송 및 물류, 기타) 및 지역별(북미, 유럽, 아시아 태평양, 중동 및 아프리카, 남미) 지능형 문서 처리 시장 조사 보고서 - 2034년까지 시장 전망
ID: MRFR/ICT/9148-CR 156 Pages Ankit Gupta, Shubham Munde Last Updated: September 15, 2026
Intelligent Document Processing Market
Market Size
Forecast Period2026-2035
CAGR (2026-2035)16.45%
2025 Market SizeUSD 2.86 Billion
2035 Market SizeUSD 13.48 Billion
Key Players
ABBYY
Microsoft
Google
IBM
Kofax
UiPath
Opportunities
  • Generative-AI-Augmented Document Understanding
  • SME-Focused SaaS Platforms
  • Emerging-Market Digitization Programs

Intelligent Document Processing Market Summary

지능형 문서 처리 시장은 2025년에 약 28억 6천만 달러에 도달할 것으로 예상되며, 2026년에는 33억 8천만 달러로 시작하여 2035년까지 134억 8천만 달러로 증가할 것으로 보이며, 연평균 성장률(CAGR)은 16.45%입니다. 이 확장을 이끄는 두 가지 힘은 기업 전반에 걸친 백오피스 운영의 디지털화 의무와 EU AI 법의 투명성 요구 사항을 포함한 새로운 AI 규제 프레임워크입니다. 이는 조직이 자동화된 파이프라인을 통해 문서가 흐르는 방식을 감사하도록 강요합니다 [2]. 보험사만 해도 2028년까지 직통 청구 처리 기술에 42억 달러 이상을 지출할 것으로 예상되며, 이는 AI 문서 추출 수요에 직접적으로 연결됩니다.

반구조화된 송장, 다국어 계약 및 손으로 쓴 양식에 어려움을 겪는 기존의 광학 문자 인식 엔진은 컴퓨터 비전과 맥락적 언어 이해를 결합한 변환기 기반 모델로 점차 대체되고 있습니다. 이 변화는 점진적이지 않습니다 — 문서 워크플로 자동화를 배포하는 기업들은 롤아웃 첫 해에 수동 데이터 입력 시간을 60–75% 줄였다고 보고하고 있습니다. 주요 클라우드 제공업체들은 지능형 처리 API를 플랫폼 스택에 통합하여 중소기업 구매자에 대한 진입 장벽을 낮추고, 역사적으로 종이 중심의 프로세스에 의존했던 부문에서 자동화된 데이터 캡처 채택을 가속화하고 있습니다 [5].

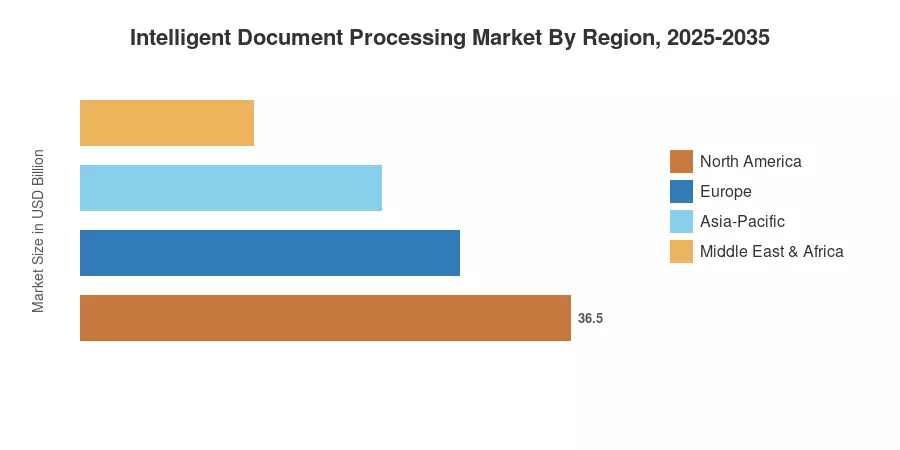
북미는 지능형 문서 처리 시장의 약 38%를 차지하며, 금융 서비스 디지털화 및 연방 현대화 프로그램에 기반을 두고 있습니다. 아시아-태평양 지역은 인도의 디지털 인디아 이니셔티브와 중국의 스마트 정부 문서 시스템 추진에 힘입어 2035년까지 18.25%의 CAGR로 가장 빠르게 성장하는 지역입니다. 유럽은 약 27%의 두 번째로 큰 점유율을 차지하며, GDPR 준수 및 국경 간 은행 조화가 OCR 지능형 처리 및 비구조적 문서 AI 플랫폼에 대한 수요를 유지하고 있습니다.


주요 보고서 요약

• 구성 요소별

  • 소프트웨어 플랫폼은 2025년 지능형 문서 처리 시장의 약 67%를 차지하며, 이는 구성 가능한 AI 문서 추출 제품군에 대한 기업의 선호를 반영합니다.
  • 서비스는 시스템 통합 및 관리 서비스 참여가 증가함에 따라 2035년까지 17.65%의 CAGR로 확장되고 있습니다.

• 배포 모드별

  • 클라우드 배포는 2025년에 약 21억 8천만 달러를 차지하며, 확장 가능하고 실시간 문서 워크플로 자동화 인프라로의 전환을 강조합니다.
  • 온프레미스 솔루션은 데이터 거주가 필요한 방위 및 규제된 의료 환경에서 여전히 중요합니다.

• 기술별

  • 광학 문자 인식은 2025년 지능형 문서 처리 시장의 44% 점유율을 차지했습니다.
  • 자연어 처리는 가장 빠르게 성장하는 기술 세그먼트로, 기업들이 원시 OCR 지능형 처리 이상의 맥락적 이해를 요구함에 따라 21.15%의 CAGR로 성장하고 있습니다.

• 최종 사용자 산업별

  • 은행, 금융 서비스 및 보험은 2025년 지능형 문서 처리 시장의 30.5% 점유율로 최종 사용자 지출을 주도했습니다.
  • 의료 및 생명 과학은 전자 건강 기록 의무와 임상 시험을 위한 자동화된 데이터 캡처에 힘입어 19.35%의 CAGR로 확장할 것으로 예상됩니다.

• 지역별

  • 북미는 2025년 지능형 문서 처리 시장에서 38%의 수익 점유율로 선두를 차지했습니다.
  • 아시아-태평양 지역은 2035년까지 18.25%의 가장 높은 지역 CAGR로 성장하고 있습니다.


시장 규모 및 예측 (2021–2035)

Market Research Future (MRFR)의 추정치는 120명 이상의 산업 이해관계자와의 주요 인터뷰, 공급업체 재무 공개, 특허 출원 분석 및 공개적으로 이용 가능한 벤치마크에 맞춰 조정된 독점적인 수요 측 모델링을 결합한 것입니다. 역사적 값(2021–2024)은 감사된 수익 신고에서 파생되며, 예측 값(2026–2035)은 하향식 세분화 교차 검증을 통해 검증된 복합 성장 궤적을 적용합니다.
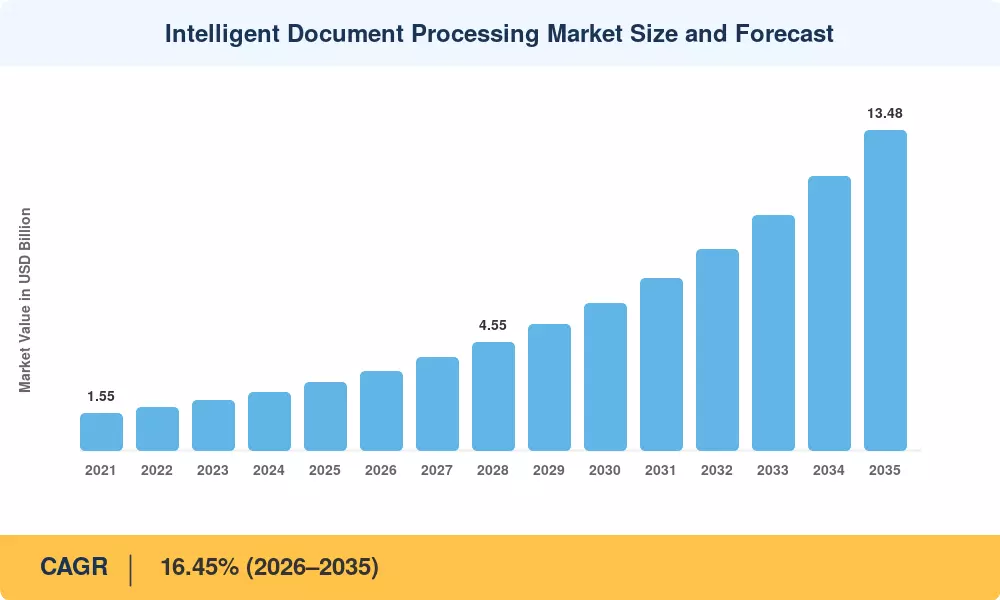
지능형 문서 처리 시장 규모 및 예측
Our Impact

Enabled $4.3B Revenue Impact for Fortune 500 and Leading Multinationals

Partnering with 2000+ Global Organizations Each Year

30K+ Citations by Top-Tier Firms in the Industry

드라이버 영향 분석

드라이버 ~% CAGR에 대한 영향 지리적 관련성 영향 타임라인 참조
AI 및 머신러닝 모델 성숙 22% 글로벌 중기 (2–4년) [6]
클라우드 플랫폼 확산 18% 북미, 유럽 단기 (≤2년) [5]
규제 준수 의무 16% 유럽, 북미 단기 (≤2년) [2]
비구조적 데이터 양 증가 15% 글로벌 장기 (≥4년)
원격 및 하이브리드 근무 채택 12% 글로벌 단기 (≤2년)
사기 탐지 지출 증가 10% 북미, 아시아 태평양 중기 (2–4년)
수직 산업 AI 미세 조정 7% 아시아 태평양, 유럽 장기 (≥4년)

AI 및 머신러닝 모델 성숙

변환기 아키텍처와 대형 언어 모델은 자동화된 데이터 캡처가 달성할 수 있는 것을 재구성했습니다. 기존 OCR 지능형 처리의 정확도가 반구조적 문서에서 78–82%에 그쳤던 반면, 현재의 다중 모달 모델은 송장, 구매 주문서 및 보험 청구서에서 95%를 초과하는 성능을 자주 보입니다 [6]. Google의 Document AI와 Microsoft의 Azure AI Document Intelligence는 이제 150개 이상의 문서 유형에 대해 사전 훈련된 추출기를 제공하여 배포 시간을 몇 개월에서 며칠로 단축했습니다. 미국 국립표준기술연구소(NIST)는 AI 보강 추출이 2024년 다섯 개의 파일럿 기관에서 연방 양식 처리 적체를 43% 줄였다고 보고했습니다 [11].

클라우드 플랫폼 확산

전문 데이터 과학 팀이 없는 조직도 이제 하이퍼스케일 클라우드 제공업체의 지능형 처리 변환 덕분에 문서 워크플로우 자동화에 접근할 수 있습니다. AWS, Azure 및 GCP는 관리되는 IDP 서비스를 통해 매 분기 120억 페이지 이상의 문서를 처리합니다 [5]. 이제 지능형 문서 처리 시장에서 가장 빠르게 성장하는 구매 집단을 구성하는 중소기업들은 페이지당 지불하는 소비 모델이 매우 매력적이라고 느끼고 있습니다.

규제 준수 의무

EU AI 법의 제14조 투명성 의무는 기업이 신원 문서 및 재무 기록을 처리하는 고위험 AI 시스템에 대한 인간 감독 메커니즘을 입증하도록 요구합니다 [2]. 미국에서는 OCC의 2024년 모델 위험 관리에 대한 지침(SR 11-7 업데이트)이 대출 origination에 사용되는 AI 문서 추출 파이프라인을 명시적으로 다룹니다 [12]. 이러한 규제는 채택을 늦추지 않고 있으며, 오히려 감사 가능하고 설명 가능한 플랫폼으로 지출을 재조정하고 있습니다.

비구조적 데이터 양 증가

최근 연구에 따르면 기업 데이터의 80%가 비구조적이며, 그 양은 매년 28% 증가하고 있습니다. 계약서, 이메일, 의료 기록 및 배송 명세서는 전통적인 데이터베이스 저장소에 저항하여 비구조적 문서 AI 솔루션에 대한 지속적인 수요를 창출하고 있습니다. 이러한 솔루션은 수동 개입 없이 정보를 분류, 추출 및 라우팅할 수 있습니다.

제한 요소 영향 분석

제한 요소 영향 비율은 섹션 4에서 설명한 동일한 방향 추정 방법론을 따릅니다. 이들은 성장 궤적에 대한 저항 효과를 나타내며 CAGR에서 직접적으로 차감되지 않습니다.

제한 요소 ~% CAGR에 대한 부정적 영향 지리적 관련성 영향 타임라인 참조
데이터 프라이버시 및 주권 문제 –5% 유럽, 아시아-태평양 중기 [13]
구형 시스템과의 높은 통합 복잡성 –4% 글로벌 단기
손으로 쓴 문서 및 저하된 문서에 대한 정확성 제한 –3% 글로벌 장기 [6]
전문 AI/ML 인재 부족 –3% 북미, 유럽 중기 [15]
공급업체 종속 및 상호 운용성 격차 –2% 글로벌 중기

데이터 프라이버시 및 주권 문제

복잡한 데이터 거주 요구 사항은 국경 간 문서 처리로 인해 발생합니다. 다국적 은행 및 보험사는 GDPR의 EEA 외부로 개인 데이터를 전송하는 금지로 인해 지역별 IDP 인스턴스를 구현해야 하며, 이는 단일 테넌트 글로벌 배포에 비해 인프라 비용을 15–25% 증가시킵니다 [13]. 인도의 디지털 개인 데이터 보호법(2023)도 금융 및 의료 기록에 대한 유사한 현지화 요구 사항을 도입하여, 지능형 문서 처리 시장을 추진하는 클라우드 가치 제안을 분할합니다.

구형 시스템 통합 복잡성

2024년 조사에 따르면, 58%의 기업이 핵심 ERP 및 클레임 관리 플랫폼과의 통합 실패로 인해 최소한 하나의 문서 워크플로 자동화 파일럿을 포기했습니다. 메인프레임에 의존하는 은행 및 정부 기관은 가장 큰 장애물에 직면하고 있으며, COBOL 기반 백 엔드는 비용이 많이 드는 미들웨어 계층 없이 현대 API 출력을 소비할 수 없습니다. 미리 구축된 커넥터가 성숙해질 때까지, 통합 저항은 구형 시스템이 풍부한 수직 시장에서 자동 데이터 캡처의 채택 속도를 계속 제한할 것입니다.

Intelligent Document Processing Market Opportunities

생성적 AI 증강 문서 이해

텍스트 추출기에서 문서 추론 엔진에 이르기까지, 대형 언어 모델이 개발되고 있습니다. 지능형 문서 처리 시장의 가치의 다음 경계는 하위 프로세스를 자동으로 채우고 비표준 용어를 감지하며 200페이지 계약을 40% 짧은 계약 검토 주기로 요약할 수 있는 플랫폼으로 나타납니다. 법률 서비스 산업의 초기 수용자들은 [6]에서 보고했습니다.

중소기업 중심의 SaaS 플랫폼

평균적으로 월 12,000개의 문서를 처리함에도 불구하고, 중소기업은 맞춤 배포를 위한 전문 IT 팀이 부족합니다. 추출, 검증 및 파일링을 단일 구독으로 결합함으로써, 회계 사무소, 물류 중개인 및 의료 클리닉을 위한 사전 구성된 템플릿을 제공하는 수직 SaaS 제공업체들은 자동화된 데이터 캡처 시장의 빠르게 확장되는 부분을 차지할 수 있습니다.

신흥 시장 디지털화 프로그램

인도의 통합 결제 인터페이스는 2024년 한 달 동안 146억 건의 거래를 처리하여 KYC 문서 검증에 대한 막대한 하위 수요를 생성했습니다. [17] 유사하게, 브라질의 픽스 즉시 결제 생태계와 사우디 아라비아의 비전 2030 전자 정부 의무는 지역 언어 및 문서 형식에 맞게 모델을 현지화할 의향이 있는 OCR 지능형 처리 공급업체를 위한 새로운 기회를 창출하고 있습니다.

데이터 수익화 및 분석 오버레이

추출된 문서 데이터는 익명화되고 집계될 때 귀중한 분석 자산이 됩니다. 예를 들어, 보험사는 지리별 청구 패턴을 벤치마킹할 수 있고, 물류 회사는 대규모로 배송 문서를 분석하여 공급망 병목 현상을 감지할 수 있습니다. 비구조적 문서 AI 추출 엔진 위에 분석 대시보드를 추가하는 공급업체는 프리미엄 가격과 더 높은 유지율을 요구할 것입니다.

산업 간 컴플라이언스 서비스

전 세계적으로 규제 복잡성이 증가함에 따라, AI 문서 추출 플랫폼이 진화하는 규제에 맞춰 추출 규칙을 지속적으로 업데이트하는 컴플라이언스 서비스 모델은 2030년까지 약 18억 달러의 반복 수익 기회를 제공합니다. [2]

Intelligent Document Processing Market Future Outlook

자율 문서 에이전트

2030년까지 지능형 문서 처리 시장은 추출 중심 도구에서 인간의 개입 없이 읽고, 해석하고, 결정하고, 행동할 수 있는 완전 자율 문서 에이전트로 전환될 것입니다. 초기 프로토타입은 이미 5,000달러 이하의 보험 청구를 97%의 정확도로 자동 판별하고 있습니다 [6]. 신뢰 기준이 높아짐에 따라 이러한 에이전트는 점점 더 복잡한 문서 — 합병 계약, 임상 시험 제출, 다중 관할 세금 신고 — 를 처리하여 처리 시간을 며칠에서 몇 분으로 단축할 것입니다.

플랫폼 통합 및 생태계 경제학

공급업체 환경은 문서 생애 주기 관리의 끝에서 끝까지 제공하는 플랫폼 플레이어를 중심으로 통합될 것입니다: 수집, 분류, 추출, 검증, 라우팅 및 보관. 하이퍼스케일러는 클라우드 스택에 기능을 본격적으로 통합하기 위해 틈새 AI 문서 추출 스타트업을 인수하고 있으며, 2032년까지 상위 5개 플랫폼이 지능형 문서 처리 시장의 55-60%를 차지할 것으로 예상됩니다. 더 작은 공급업체는 의료 및 법률과 같은 분야에서 깊은 수직 전문성을 제공하여 생존할 것입니다.

다중 모드 및 다국어 AI

다음 세대의 비구조화 문서 AI는 단일 모델 패스 내에서 텍스트, 이미지, 표 및 손글씨를 동시에 처리할 것입니다. 아랍어, 힌디어, 중국어를 포함한 50개 이상의 언어를 지원하는 다국어 지원은 프리미엄 기능이 아닌 기본 요구 사항이 되어 현재 채택이 뒤처진 신흥 시장을 열 것입니다. 시장 조사 미래(MRFR)는 다국어 IDP 기능이 2035년까지 14억 달러의 추가 수익을 창출할 것으로 추정합니다.

지속 가능성 및 ESG 보고 자동화

SEC(기후 공시 규칙), EU의 CSRD, 인도의 BRSR를 포함한 규제 기관은 다양한 내부 문서에서 추출된 구조화된 ESG 공시를 의무화하고 있습니다. 공공 요금 청구서, 공급망 감사 및 배출 인증서를 수집할 수 있는 자동 데이터 캡처 플랫폼은 필수적인 준수 인프라가 되어 지능형 문서 처리 시장의 장기 성장 궤적을 강화하는 반복 수익 기회를 창출할 것입니다 [21].

지역 시장 점유율 분석

지역 주요 지표 주요 투자 주제
북미 38% 점유율 (2025) 금융 서비스 자동화, 연방 현대화
유럽 27% 점유율 (2025) GDPR 준수, 국경 간 은행 조화
아시아-태평양 18.25% CAGR (2026–2035) 디지털 정부 프로그램, 핀테크 KYC
남미 USD 0.17억 (2025) 오픈 뱅킹 의무, 중소기업 디지털화
중동 및 아프리카 15.85% CAGR (2026–2035) 비전 2030, 석유 및 가스 문서 워크플로우
총계 USD 2.86억 (2025) —

지능형 문서 처리 시장은 규제 성숙도, 클라우드 인프라 밀도 및 인력 디지털화 수준에 따라 형성된 뚜렷한 채택 곡선을 가진 다섯 개의 주요 지역으로 나뉩니다.

북미

국가 주요 지표 주요 동인
미국 지역 점유율의 78% 연방 기관의 제로 트러스트 디지털화 의무 [11]
캐나다 14.5% CAGR (2026–2035) 의료 시스템 문서 현대화
멕시코 USD 0.04억 (2025) 근거리 물류 문서량

미국은 북미 지출의 대부분을 차지하며, 재향군인부는 2024년에 AI 문서 추출 계약을 통해 9억 개 이상의 레거시 의료 기록을 디지털화하고 있습니다 [11]. 캐나다의 주 보건 당국은 환자 기록 교환을 통합하기 위해 클라우드 기반 문서 워크플로우 자동화 플랫폼을 표준화하고 있습니다. 멕시코의 제조 근거리화 붐은 자동화된 데이터 캡처 솔루션을 선호하는 세관 문서 처리의 급증을 초래하고 있습니다.

유럽

국가 주요 지표 주요 동인
독일 지역 점유율의 23% 산업 4.0 공급망 문서화
영국 18.15% CAGR (2026–2035) 브렉시트 이후 무역 문서 디지털화
프랑스 USD 0.12억 (2025) 공공 부문 디지털 전환
이탈리아 13.85% CAGR (2026–2035) 은행 통합 및 NPL 처리
스페인 USD 0.07억 (2025) 관광 부문 신원 확인
북유럽 국가 15.90% CAGR (2026–2035) 고급 디지털 정부 생태계
러시아 USD 0.04억 (2025) 수입 대체 IT 정책
유럽 나머지 지역 점유율의 12% EU 응집력 기금 디지털화 프로그램

독일의 미텔슈탄드 제조업체들은 다단계 공급업체 네트워크 전반에 걸쳐 추적 가능한 문서를 요구하는 공급망 실사법(LkSG)을 준수하기 위해 조달 워크플로우에 OCR 지능형 처리를 통합하고 있습니다 [18]. 영국의 HMRC는 브렉시트로 인해 2021년과 2024년 사이에 세 배로 증가한 무역 양식 볼륨에 따라 자동화된 세관 신고 처리에 3억 2천만 파운드를 투자하기로 약속했습니다.

아시아-태평양

국가 주요 지표 주요 동인
중국 지역 점유율의 32% 스마트 정부 및 핀테크 확장
인도 21.50% CAGR (2026–2035) 디지털 인도 및 UPI 기반 KYC 볼륨 [17]
일본 USD 0.09억 (2025) 노령 인구가 노동 대체 AI를 추진
한국 17.20% CAGR (2026–2035) 디지털 뉴딜 2.0 공공 부문 자동화
ASEAN USD 0.06억 (2025) 국경 간 무역 문서 조화
아시아-태평양 나머지 14.95% CAGR (2026–2035) 신흥 핀테크 생태계

아시아-태평양은 지능형 문서 처리 시장에서 가장 빠르게 성장하는 지역으로, 인도와 중국이 지역 수요의 절반 이상을 차지하고 있습니다. 인도의 아드하르 연계 문서 검증 생태계는 매일 1억 건 이상의 인증 요청을 처리하여 방언 언어와 가변 문서 품질을 처리할 수 있는 비구조적 문서 AI 솔루션에 대한 막대한 수요를 창출하고 있습니다 [17].

남미

국가 주요 지표 주요 동인
브라질 지역 점유율의 62% 픽스 생태계 및 오픈 뱅킹 규제
아르헨티나 16.45% CAGR (2026–2035) 금융 포용 디지털화
남미 나머지 USD 0.03억 (2025) 상품 수출 문서화

브라질 중앙은행은 2024년 모든 사업 규모에 대해 표준화된 디지털 청구서(NF-e)를 의무화하여 이전에 수동 장부 기록에 의존하던 중소기업들 사이에서 자동화된 데이터 캡처 채택의 물결을 촉발했습니다 [19]. 아르헨티나의 핀테크 부문은 2024년 거래량이 48% 증가하면서 온보딩 및 준수 워크플로우에서 AI 문서 추출에 대한 수요를 이끌고 있습니다.

중동 및 아프리카

국가 주요 지표 주요 동인
사우디아라비아 지역 점유율의 35% 비전 2030 전자 정부 디지털화
UAE 18.65% CAGR (2026–2035) 자유무역지대 무역 문서 자동화
남아프리카 USD 0.02억 (2025) 은행 부문 KYC 현대화
이집트 15.10% CAGR (2026–2035) 국가 디지털 신원 배포
MEA 나머지 지역 점유율의 13% 석유 및 가스 자산 문서화 디지털화

사우디아라비아의 디지털 인증 국가 센터는 2024년에 발표된 12억 달러 규모의 디지털 정부 투자 패키지의 일환으로 22개 정부 부처에 걸쳐 문서 워크플로우 자동화를 배포하고 있습니다 . UAE의 DIFC 및 ADGM 자유무역지대는 기계 판독 가능한 규제 제출을 의무화하여 금융 기업들이 아랍어 지원 OCR 지능형 처리 플랫폼으로 나아가도록 하고 있습니다.

지능형 문서 처리 시장 지역별, 2025-2035

Intelligent Document Processing Market Segmentation

구성 요소별

세그먼트 주요 지표 주요 수요 동인
소프트웨어 67% 점유율 (2025) 사전 훈련된 추출 모델 및 저코드 구성
서비스 17.65% CAGR (2026–2035) 구현, 교육 및 관리 서비스 참여

소프트웨어 플랫폼은 구매자들이 기존 문서 워크플로우 자동화 스택과 통합되는 구성 가능한 API 기반 제품을 선호함에 따라 지능형 문서 처리 시장을 지배하고 있습니다. ABBYY 및 Kofax와 같은 공급업체는 고객이 산업별 추출기를 다운로드할 수 있는 모델 마켓플레이스에 대규모로 투자했습니다. 한편, 서비스 세그먼트는 기업들이 95% 이상의 정확도를 달성하기 위해 도메인별 모델 미세 조정, 변화 관리 및 지속적인 최적화가 필요하다는 것을 깨닫으면서 가속화되고 있습니다 — 이러한 작업은 전문 통합업체를 요구합니다.

배포 모드별

세그먼트 주요 지표 주요 수요 동인
클라우드 USD 21억 (2025) 확장성, 실시간 업데이트, 페이지당 요금
온프레미스 11.75% CAGR (2026–2035) 데이터 거주지, 방어 및 기밀 문서 처리

클라우드 배포는 초기 인프라 비용을 제거하고 세금 시즌이나 오픈 등록 기간과 같은 피크 기간 동안 처리 용량을 확장할 수 있는 능력에 의해 지능형 문서 처리 시장의 신규 진입자에게 기본 옵션이 되고 있습니다. 온프레미스 설치는 방어, 정보 및 고도로 규제된 제약 환경에서 지속되고 있으며, 여기서 자동화된 데이터 캡처는 공기 간섭 네트워크 내에서 이루어져야 합니다 [13].

기술별

세그먼트 주요 지표 주요 수요 동인
광학 문자 인식 44% 점유율 (2025) 디지털 문서의 기본 텍스트 추출 레이어
자연어 처리 21.15% CAGR (2026–2035) 계약, 청구 및 서신의 맥락 이해
컴퓨터 비전 USD 3억 1천만 (2025) 표 추출, 서명 감지, 이미지 분류
기계 학습 / 딥 러닝 19.85% CAGR (2026–2035) 피드백 루프를 통한 지속적인 정확도 개선

OCR 지능형 처리는 기본 기술 레이어로 남아 있지만, NLP 및 딥 러닝 모델이 OCR만으로는 해결할 수 없는 분류 및 검증 작업을 흡수함에 따라 그 지배력이 약화되고 있습니다. 가장 빠르게 성장하는 AI 문서 추출 사용 사례 — 계약 분석, 의료 기록 요약 및 규제 제출 파싱 — 는 문자뿐만 아니라 의미를 이해하는 NLP의 능력에 의존하고 있습니다 [6].

기업 규모별

세그먼트 주요 지표 주요 수요 동인
대기업 69% 점유율 (2025) 복잡한 다부서 문서 워크플로우
중소기업 17.85% CAGR (2026–2035) SaaS 접근성 및 미리 구축된 템플릿

대기업은 조달, 인사, 재무 및 준수 기능 전반에 걸쳐 매년 수백만 개의 문서를 처리하기 때문에 지능형 문서 처리 시장의 대부분을 차지합니다. 그러나 중소기업은 성장 스토리입니다 — 클라우드 네이티브 플랫폼은 페이지당 투명한 가격 책정으로 최소한의 투자 비용을 월 500달러 이하로 줄여, 매달 5,000페이지를 처리하는 기업에게 자동화된 데이터 캡처를 경제적으로 가능하게 했습니다.

최종 사용자 산업별

세그먼트 주요 지표 주요 수요 동인
은행, 금융 서비스 및 보험 30.5% 점유율 (2025) KYC, 청구 처리 및 대출 발급
정부 및 공공 부문 USD 4억 6천만 (2025) 시민 서비스 현대화 의무
의료 및 생명 과학 19.35% CAGR (2026–2035) EHR 디지털화 및 임상 시험 문서 관리
소매 및 전자 상거래 16.80% CAGR (2026–2035) 청구서 처리, 반품 문서
기타 산업 12% 점유율 (2025) 제조, 에너지, 물류

BFSI는 KYC 온보딩, 모기지 처리, 무역 금융 문서 및 청구 판별에 걸쳐 비구조적 문서 AI가 배포되면서 지능형 문서 처리 시장의 중심 수직으로 남아 있습니다. 의료 분야는 병원과 제약 회사들이 환자 기록, 규제 제출 및 임상 시험 사례 보고서를 디지털화하기 위해 경쟁하면서 급증하고 있으며, 이는 FDA 및 EMA의 전자 제출 의무가 강화되고 있습니다 [21].

경쟁 벤치마킹

지능형 문서 처리 시장은 중간 집중도를 보이며, 상위 5개 공급업체가 전 세계 수익의 약 38–45%를 차지하고 있습니다. 허핀달-허쉬만 지수(HHI)는 900–1,100 범위에 위치하여, 기존 플랫폼 업체들이 전문 AI 스타트업과 경쟁하는 중간 정도의 분산된 환경을 나타냅니다. 2023년 이후 M&A 활동이 강화되었으며, 하이퍼스케일러들이 틈새 문서 워크플로 자동화 공급업체를 인수하여 추출 기능을 기업 클라우드 스위트에 직접 통합하고 있습니다.

회사 추정 수익 점유율 범위 주요 제품 전략적 포지셔닝
ABBYY ~8–11% Vantage 플랫폼, FlexiCapture, Timeline 프로세스 인텔리전스 + AI 문서 추출 통합
Microsoft ~7–10% Azure AI 문서 인텔리전스, Syntex 하이퍼스케일 클라우드 네이티브, M365 생태계와 번들
Google ~6–9% 문서 AI, 클라우드 비전 API 다국어 NLP를 갖춘 사전 훈련된 모델
IBM ~5–8% Datacap, Watson Discovery, Cloud Pak for Data 하이브리드 클라우드, 규제 산업 집중
Kofax (Tungsten Automation) ~5–7% TotalAgility, 지능형 자동화 플랫폼 은행을 위한 종합 문서 워크플로 자동화
UiPath ~4–7% 문서 이해, 커뮤니케이션 마이닝 RPA 네이티브, 봇 워크플로에 내장된 자동 데이터 캡처
Hyland ~3–5% OnBase, Brainware 콘텐츠 서비스 + 헬스케어 수직 전문화
Automation Anywhere ~3–5% IQ Bot, 문서 자동화 RPA와 IDP의 융합 전략
Hyperscience ~2–4% Hyperscience 플랫폼 보험 및 정부를 위한 인간-루프 정확도
Instabase ~2–3% AI 허브, Converse 생성 AI 우선, 개발자 중심 플랫폼

최근 뉴스 및 개발 사항

  • ABBYY (2023년 9월): 대형 언어 모델 통합을 통해 지능형 문서 처리 시장에서 이전에 보지 못한 문서 유형에 대한 제로샷 추출을 가능하게 하는 Vantage 2.5를 출시했습니다.
  • Microsoft (2023년 11월): Azure AI Document Intelligence를 30개 추가 언어를 지원하도록 확장하고, 북미 대출에서 AI 문서 추출을 가속화하는 사전 구축된 모기지 문서 모델을 도입했습니다 [5].
  • UiPath (2022년 8월): 고객 서비스 자동화를 위한 비구조적 문서 AI의 Communications Mining 제품 강화를 위해 NLP 스타트업 Re: infer를 1억 8500만 달러에 인수했습니다.
  • 유럽연합 집행위원회 (2024년 3월): EU AI 법안 프레임워크를 공식화하여 개인 신원 문서를 처리하는 고위험 자동 데이터 캡처 시스템에 대한 감사 추적 요구 사항을 포함한 준수 일정 및 기술 표준을 설정했습니다 [2].

Intelligent Document Processing Market Report Scope

자주 묻는 질문

지능형 문서 처리와 전통적인 OCR의 차이점은 무엇인가요?
전통적인 OCR은 이미지를 텍스트로 변환하지만 맥락, 관계 또는 의미를 해석할 수 없습니다. 지능형 문서 처리 시장은 OCR을 기반으로 NLP, 기계 학습 및 컴퓨터 비전을 레이어링하여 복잡한 문서에서 데이터를 자율적으로 분류, 추출 및 검증합니다 [6].
IDP 배포의 일반적인 ROI 타임라인은 어떻게 되나요?
대부분의 기업은 수동 처리 노동에서 60–70%의 감소로 인해 9–14개월 이내에 투자를 회수합니다. 문서 워크플로 자동화가 해외 BPO 계약을 대체할 때 상환이 가속화됩니다 .
규제 산업에 더 적합한 배포 모델은 클라우드인가요, 온프레미스인가요?
방어 및 기밀 정부 운영과 같은 강력하게 규제된 분야는 공기 차단 보안을 위해 온프레미스 배포를 선호합니다. 그러나 대부분의 은행 및 의료 구매자는 이제 데이터 거주 규칙을 충족하면서 확장성을 유지하는 하이브리드 클라우드 아키텍처를 채택하고 있습니다 [13].
생성 AI 모델이 지능형 문서 처리 시장을 어떻게 재편하고 있나요?
생성 AI는 제로샷 추출을 가능하게 하여 시스템이 이전에 본 적이 없는 문서 유형을 재교육 없이 처리합니다. 이는 템플릿 구성에 몇 주가 걸리는 과정을 없애고 AI 문서 추출을 긴 꼬리 문서 카테고리에 적합하게 만듭니다 [6].
구매자는 현대 IDP 플랫폼에서 어떤 정확도 기준을 기대해야 하나요?
선도적인 플랫폼은 구조화된 및 반구조화된 문서에서 93–97%의 직통 처리율을 달성합니다. 손글씨 및 품질 저하 입력은 일반적으로 85–90%의 점수를 기록하며, 인간 검증이 필요합니다 .
지능형 문서 처리 시장은 다국어 문서 문제를 어떻게 해결하나요?
현재 플랫폼은 다국어 변환 모델을 사용하여 40–60개 언어를 지원합니다. 아랍어, 힌디어 및 CJK 스크립트는 라틴 기반 언어보다 더 어렵지만, 전이 학습 기술로 정확도 격차가 빠르게 좁혀지고 있습니다 [6].
지능형 문서 처리 시장은 ESG 준수에서 어떤 역할을 하나요?
자동화된 데이터 캡처 플랫폼은 공과금 청구서, 감사 보고서 및 공급망 인증서에서 지속 가능성 지표를 추출하여 기업이 SEC, CSRD 및 BRSR 의무에 필요한 구조화된 ESG 공시를 작성할 수 있도록 합니다 [21].    
저자
저자 Author Profile Ankit Gupta LinkedIn Team Lead - Research
Ankit Gupta is a seasoned market intelligence and strategic research professional with over six plus years of experience in the ICT and Semiconductor industries. With academic roots in Telecom, Marketing, and Electronics, he blends technical insight with business strategy. Ankit has led 200+ projects, including work for Fortune 500 clients like Microsoft and Rio Tinto, covering market sizing, tech forecasting, and go-to-market strategies. Known for bridging engineering and enterprise decision-making, his insights support growth, innovation, and investment planning across diverse technology markets.
공동 저자 Co-Author Profile Shubham Munde LinkedIn Team Lead - Research
Shubham brings over 7 years of expertise in Market Intelligence and Strategic Consulting, with a strong focus on the Automotive, Aerospace, and Defense sectors. Backed by a solid foundation in semiconductors, electronics, and software, he has successfully delivered high-impact syndicated and custom research on a global scale. His core strengths include market sizing, forecasting, competitive intelligence, consumer insights, and supply chain mapping. Widely recognized for developing scalable growth strategies, Shubham empowers clients to navigate complex markets and achieve a lasting competitive edge. Trusted by start-ups and Fortune 500 companies alike, he consistently converts challenges into strategic opportunities that drive sustainable growth.

Research Approach

Research Methodology on Intelligent Document Processing Market

1. Introduction

This research report on the global Intelligent Document Processing Market examines the drivers, restraints and trends shaping the current market dynamics and assesses the business strategies adopted by major industry players. The research aims to evoke a better understanding of the competitive landscape while specifying their focus on innovation, technology, collaboration and acquisition.

2. Research Objectives

The primary objective of this research report is to gain an in-depth understanding of the global Intelligent Document Processing Market, focusing on its current and future market trends, growth drivers and opportunities. This will be done so through a thorough analysis of the industry and its associated segments. The research also aims to identify and measure the current adoption level of intelligent document processing to gain a deeper insight into how technology and process automation are impacting business operations.

3. Research Design

The research study is conducted using qualitative and quantitative analysis methods. An analysis of the market is conducted using a top-down approach and the custom market size for Intelligent Document Processing is estimated for the 2023-2030 period. Secondary data from sources such as press releases, company websites, and financial reports from key industry participants, as well as other data sources such as survey data, analysts’ opinions and reports, is also obtained.

The survey is conducted among staff from different departments in information technology companies, as well as end-users and vendors operating in the industry. The survey is conducted over the phone and online, with participants being asked to provide detailed information about their usage and understanding of the Intelligent Document Processing market.

4. Research Methodology

The market size estimation is extrapolated using Porter's Five Forces Model, while market forecasts are conducted using the CAGR methodology. To obtain a comprehensive view of the global intelligent document processing market, the research relied on a mix of primary and secondary research. Primary research involves conducting interviews with experts from the industry, market analysts, and end-users, whereas secondary research included an extensive review of industry and government sources.

These sources include official documents of government agencies, industry players and competitors, industry journals, research reports, and regulatory filings. The survey data is combined with qualitative analysis of the market landscape and the macro and micro factors that are likely to impact the demand and growth of the sector.

5. Assumptions

The study is conducted globally and the findings presented in this report are based on the assumption that the industry operates similarly across all regions. Data availability might vary considerably depending on the geographical region and is not always easily accessible. This could lead to difficulty in obtaining the required data or deriving accurate inferences. Additionally, market forecasts are based on various macroeconomic and industry-specific assumptions and may be subject to certain limitations.

무료 샘플 다운로드

이 보고서의 무료 샘플을 받으려면 아래 양식을 작성하십시오

Global Diameter Signaling Market
사례 연구
Information and Communications Technology
Download PDF ×

We do not share your information with anyone. However, we may send you emails based on your report interest from time to time. You may contact us at any time to opt-out.


















