Marché de l'apprentissage profond (2026 – 2035)

Taille, part et rapport de recherche du marché de l’apprentissage profond par offre (matériel, logiciels et services), par application (reconnaissance d’images et de vidéos, reconnaissance vocale et vocale, analyse PNL et texte, exploration de données et autres), par secteur d’utilisateur final (BFSI, vente au détail et commerce électronique, fabrication, soins de santé, automobile, informatique et télécommunications, gouvernement et défense, et autres), par déploiement (cloud et sur site) et par région (Amérique du Nord, Europe, Asie-Pacifique et autres). Reste du monde) – Prévisions de l’industrie jusqu’en 2035
ID: MRFR/ICT/4600-CR 200 Pages Nirmit Biswas, Aarti Dhapte Last Updated: September 15, 2026
Deep Learning Market
Market Size
Forecast Period2026-2035
CAGR (2026-2035)33.0%
2025 Market SizeUSD 45.4 Billion
2035 Market SizeUSD 786.5 Billion
Key Players
NVIDIA Corporation
Microsoft Corporation
Alphabet Inc.
Amazon Web Services
Intel Corporation
Advanced Micro Devices
Opportunities
  • Inference Optimisation as a Distinct Product Category
  • Emerging-Market Compute Access
  • Data Monetisation and Model-as-a-Product

Deep Learning Market Summary

Le marché de l'apprentissage profond a clôturé 2025 à environ 45,4 milliards USD et entre dans la fenêtre de prévision à 60,4 milliards USD en 2026, s'étendant à 786,5 milliards USD d'ici 2035 avec un TCAC de 33,0 %. Deux catalyseurs ancrent cette trajectoire. La loi américaine CHIPS et Science a engagé 52,7 milliards USD dans la fabrication et la recherche de semi-conducteurs nationaux, dont une grande partie est dirigée vers la chaîne d'approvisionnement des accélérateurs qui forme de grands modèles . Simultanément, le règlement (UE) 2024/1689 — la loi sur l'IA de l'UE — a créé le premier régime de conformité contraignant pour les modèles à usage général, obligeant les entreprises à budgétiser des systèmes audités et documentés plutôt que des pilotes expérimentaux [3].

Les entreprises retirent une génération de pipelines de caractéristiques conçus à la main et de classificateurs basés sur des règles. Ce qui les remplace, ce sont des architectures apprises de bout en bout formées sur des clusters d'accélérateurs, avec l'inférence poussée à la périphérie. Les revenus des centres de données de NVIDIA pour l'exercice 2025 ont dépassé 115 milliards USD, un chiffre qui illustre à lui seul comment le capital a été réorienté des calculs à usage général vers le substrat d'entraînement et d'inférence du marché de l'apprentissage profond [2].

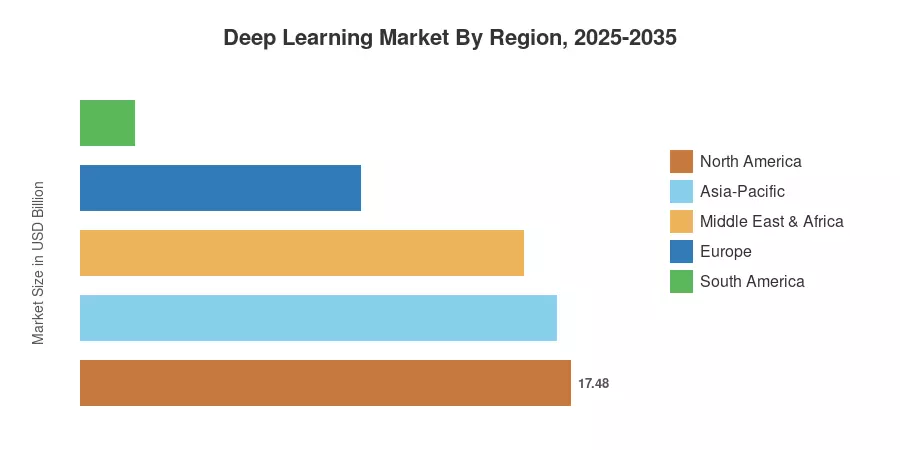
Régionalement, l'Amérique du Nord détient environ 38,5 % des revenus mondiaux, soutenue par les dépenses en capital des hyperscalers et une base de recherche dense. L'Asie-Pacifique croît le plus rapidement avec un TCAC d'environ 37,4 %, propulsée par le programme national d'IA de la Chine et la mission IndiaAI de l'Inde [13]. L'Europe suit avec environ 22,0 % de part, où la clarté réglementaire devient un atout concurrentiel plutôt qu'un frein. La prochaine décennie du marché de l'apprentissage profond sera décidée moins par la nouveauté des modèles et plus par qui peut alimenter, refroidir et gouverner le calcul.


Principales conclusions du rapport

  • Par offre


  • Le matériel représente environ 55,8 % des revenus du marché de l'apprentissage profond, reflétant la structure de coût lourde en accélérateurs des sessions d'entraînement de pointe.
  • Le logiciel est la couche d'offre à la croissance la plus rapide avec un TCAC d'environ 35,1 % à mesure que l'orchestration et les outils MLOps mûrissent.


• Par secteur d'utilisateur final


  • Le secteur BFSI domine la demande des utilisateurs finaux avec environ 18,6 % de part, soutenue par la détection de fraude et la prise de décision de crédit sous supervision de risque de modèle.
  • L'automobile affiche la croissance sectorielle la plus forte sur le marché de l'apprentissage profond avec un TCAC d'environ 39,2 % jusqu'en 2035.
  • La santé a contribué près de 5,8 milliards USD en 2025 alors que les autorisations d'imagerie diagnostique ont accéléré.

• Par région

  • L'Amérique du Nord conserve sa dominance avec environ 38,5 % des revenus du marché de l'apprentissage profond.
  • L'Asie-Pacifique s'étend à un TCAC d'environ 37,4 %, le plus rapide au monde.
  • Le Moyen-Orient et l'Afrique ont généré environ 1,73 milliard USD en 2025, peu en termes absolus mais en hausse grâce aux programmes d'IA souverains.


Taille du marché et prévisions (2021–2035)

Les chiffres ci-dessous combinent les données d'expédition des accélérateurs, les divulgations de dépenses en capital des hyperscalers dans les dépôts de la SEC, les budgets des programmes nationaux d'IA et une construction ascendante des dépenses en logiciels et services des entreprises. Les années historiques sont réconciliées avec les rapports de revenus des fournisseurs ; les années de prévision appliquent des taux de croissance pondérés par segment à la base de 2025. Lorsque la divulgation publique est partielle — développeurs de modèles privés, programmes souverains — les estimations reposent sur des dossiers d'approvisionnement et des engagements de calcul divulgués. La série du marché de l'apprentissage profond est exprimée en dollars américains constants de 2025.
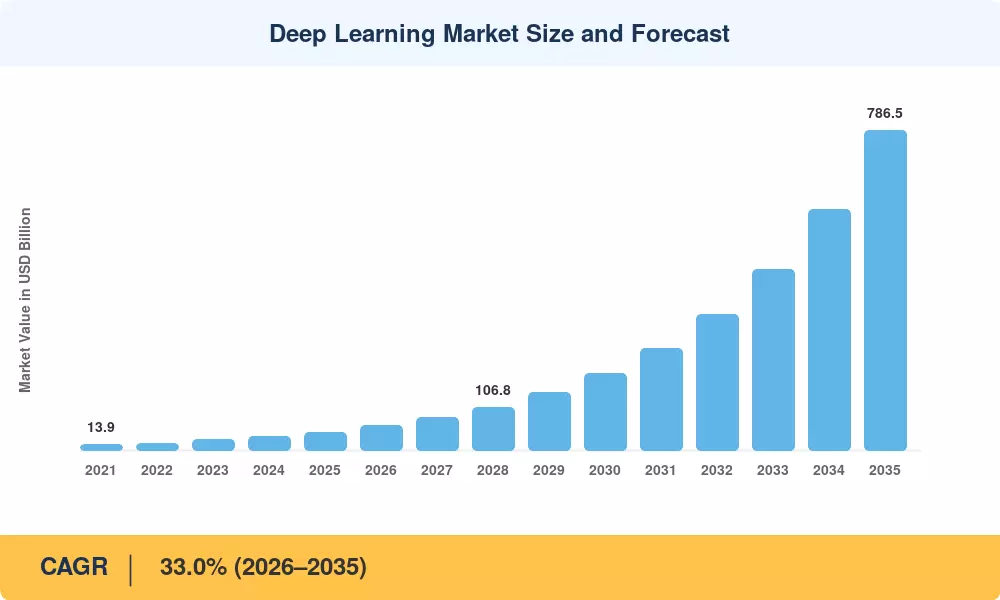
Taille et prévisions du marché de l'apprentissage profond
Our Impact

Enabled $4.3B Revenue Impact for Fortune 500 and Leading Multinationals

Partnering with 2000+ Global Organizations Each Year

30K+ Citations by Top-Tier Firms in the Industry

Analyse de l'impact des conducteurs

Conducteur ~% Impact sur le TCAC Pertinence géographique Chronologie de l'impact Réf
Gains de performance par watt de l'accélérateur 7.8 Global À court terme (≤2 ans) [2][11]
Cycles de dépenses en capital des hyperscalers 6.9 Amérique du Nord, Asie-Pacifique À court terme (≤2 ans) [8][9][10]
Financement des missions nationales en IA 5.4 Asie-Pacifique, Moyen-Orient À moyen terme (2–4 ans) [13][16]
Clarté réglementaire facilitant l'approvisionnement 4.1 Europe, Amérique du Nord À moyen terme (2–4 ans) [3][4]
Maturation du silicium pour l'inférence en périphérie 3.6 Global À moyen terme (2–4 ans) [18][19]
Élargissement du programme de mobilité autonome 3.2 Amérique du Nord, Asie-Pacifique À long terme (≥4 ans) [1]
Expansion de l'écosystème de modèles à poids ouverts 2.1 Global À long terme (≥4 ans) [21]


Économie des accélérateurs et substrat de calcul

Les améliorations de performance par watt déterminent si l'entraînement de pointe reste économiquement limité. L'architecture Blackwell de NVIDIA, introduite en mars 2024, visait une réduction matérielle de l'énergie par jeton pour l'inférence de grands modèles par rapport à sa génération précédente, et l'Instinct MI300X d'AMD a commencé les expéditions en volume en décembre 2023 en tant que seconde source crédible [2][19]. Cette pression concurrentielle est importante car l'Agence internationale de l'énergie a signalé la consommation d'électricité des centres de données comme une part croissante de la demande mondiale, avec les charges de travail en IA comme contributeur nommé [6]. Pour les acheteurs sur le marché de l'apprentissage profond, la conséquence pratique est que les calculs du coût total de possession dépendent désormais des contrats d'énergie et de la conception du refroidissement autant que du prix de liste des puces.

Dépenses en capital des hyperscalers comme plancher de demande

Trois entreprises fixent le rythme. Alphabet, Microsoft et Amazon ont collectivement orienté leurs niveaux de dépenses en capital dans leurs dépôts de 2024 et 2025, dominés par l'infrastructure IA, Microsoft attribuant explicitement une majorité de son augmentation à la capacité cloud et IA [8][9][10]. Ces dépenses créent un plancher de demande : même lorsque l'adoption par les entreprises stagne, le développement sous-jacent se poursuit sur des engagements pluriannuels.

Programmes d'IA souveraine

L'argent public est devenu un intrant structurel. Le Cabinet de l'Union indienne a approuvé la Mission IndiaAI en mars 2024 avec un budget d'environ ₹10,372 crore, finançant explicitement une installation de calcul GPU partagée [13]. La SDAIA d'Arabie Saoudite continue d'exécuter sa Stratégie nationale pour les données et l'IA, et la Stratégie nationale en IA 2031 des Émirats Arabes Unis fixe des ambitions comparables [16][17]. Le Plan d'action sur les opportunités en IA du Royaume-Uni, publié en janvier 2025, s'est engagé à élargir la capacité de calcul souveraine [14].

Réglementation comme facilitateur d'approvisionnement

Les cadres de conformité transforment l'expérimentation en programmes budgétisés. La loi sur l'IA de l'UE est entrée en vigueur en août 2024, avec des obligations pour les modèles d'IA à usage général s'appliquant à partir d'août 2025 [3]. Le Cadre de gestion des risques en IA du NIST, publié en janvier 2023, a donné aux entreprises américaines un vocabulaire de contrôle volontaire mais largement adopté [4]. Les équipes d'approvisionnement peuvent désormais rédiger des spécifications contre des normes nommées — une condition préalable à l'engagement des entreprises à grande échelle.


Analyse de l'impact des contraintes

Les pondérations des contraintes reflètent le tirage estimé que chaque facteur exerce sur la croissance réalisée par rapport à un scénario sans contrainte. Comme pour les moteurs, il s'agit de jugements directionnels des analystes appliqués au marché de l'apprentissage profond, et non d'entrées soustractives au CAGR principal.

Contrainte ~% Tirage sur le CAGR Pertinence géographique Chronologie d'impact Réf
Contraintes d'interconnexion électrique et de réseau -4.6 Amérique du Nord, Europe À court terme (≤2 ans) [6]
Pénurie de talents spécialisés -3.4 Global À moyen terme (2–4 ans) [1][25]
Limites d'approvisionnement en packaging avancé et HBM -2.9 Global À court terme (≤2 ans) [2][18]
Contrôles à l'exportation et conformité transfrontalière -2.3 Asie-Pacifique À moyen terme (2–4 ans)
Retour sur investissement non prouvé dans les pilotes -1.8 Global À long terme (≥4 ans) [25]

La disponibilité de l'énergie a remplacé l'approvisionnement en puces comme contrainte majeure

Les files d'attente d'interconnexion, et non les carnets de commandes, régulent désormais le déploiement dans plusieurs grands marchés. L'IEA a documenté une demande d'électricité pour les centres de données en forte hausse dans les économies avancées, avec des clusters dans des régions de réseau spécifiques créant une pression localisée [6]. Les opérateurs en Virginie du Nord, à Dublin et à Singapour ont tous rencontré des moratoires de connexion ou des conditions de capacité. L'effet est un allongement du délai entre l'engagement d'achat et la reconnaissance des revenus, ce qui comprime la croissance réalisée même lorsque la demande est intacte.

Concentration des talents

L'Index AI de Stanford a constamment documenté la concentration des capacités de recherche de pointe dans un petit nombre d'institutions et d'entreprises [1]. L'analyse de 2024 du FMI sur l'IA générative et les marchés du travail a noté la distribution inégale des compétences complémentaires à travers les économies [25]. Pour les acheteurs de taille intermédiaire, le résultat pratique est une dépendance aux services gérés — ce qui déplace les dépenses vers la couche de services mais limite la vitesse à laquelle la capacité interne se développe.

Goulots d'étranglement en mémoire et en packaging

La mémoire à large bande passante et la capacité de packaging avancé restent les points les plus étroits de la chaîne d'approvisionnement des accélérateurs. Les divulgations des fournisseurs jusqu'en 2024 et 2025 ont répété que l'approvisionnement était un facteur limitant sur les volumes d'expédition plutôt que la demande [2][18]. Comme les cycles de qualification pour une nouvelle capacité s'étendent sur plusieurs trimestres, le soulagement arrive avec un retard.

Deep Learning Market Opportunities

Optimisation de l'inférence en tant que catégorie de produit distincte

La formation a attiré l'attention, l'inférence génère des revenus continus. À mesure que les modèles entrent en production, l'économie change vers le coût par requête servie. Les fournisseurs proposant de la quantification, de la distillation et de l'optimisation au niveau du compilateur répondent à un besoin sur le marché de l'apprentissage profond qui évolue avec l'utilisation, et non avec le nombre de modèles. Cet aspect de la performance a été rendu publiquement comparable grâce aux benchmarks d'inférence MLPerf de MLCommons [11].


Accès à l'informatique sur les marchés émergents

Aujourd'hui, l'Amérique latine, l'Asie du Sud-Est et l'Afrique représentent moins de 10 % des revenus mondiaux, mais disposent de grandes bases d'entreprises numériques natives. Les efforts législatifs sur la gouvernance de l'IA au Brésil et les programmes de développement numérique de la Banque mondiale [23][24] signalent une demande qui n'est pas actuellement satisfaite par l'infrastructure locale. La solution réside dans les zones cloud régionales et les installations informatiques nationales partagées.


Monétisation des données et modèle en tant que produit

Les organisations disposant de corpus propriétaires et spécifiques à un domaine (registres cliniques, télémétrie industrielle, historiques de transactions) pourraient licencier des modèles affinés plutôt que des données brutes, protégeant la confidentialité et capturant de la valeur. Ce modèle commercial est nouveau mais structurellement prometteur dans le marché de l'apprentissage profond car il transforme un actif statique en revenus de licence récurrents.


Écosystèmes de modèles à poids ouverts

L'introduction par Meta de Llama 3 en avril 2024 et de Llama 3.1 avec 405 milliards de paramètres en juillet 2024 a considérablement réduit le coût d'entrée pour les organisations hésitantes à dépendre d'un seul fournisseur propriétaire [21]. L'opportunité commerciale se trouve dans la couche environnante : hébergement, outils de sécurité, évaluation et contrats de support pour les organisations qui souhaitent garder le contrôle mais ne veulent pas construire elles-mêmes des modèles de base.


Services d'assurance pour les industries réglementées

La documentation des modèles, les tests de biais et la surveillance post-commercialisation sont désormais des obligations légales en Europe pour les applications à haut risque [3]. Les entreprises capables de fournir des paquets de preuves auditables — pas seulement des modèles fonctionnels — exigeront des prix premium dans les secteurs bancaire, de l'assurance et des dispositifs médicaux.


Deep Learning Market Future Outlook

De l'entraînement des modèles aux opérations autonomes

Le centre de gravité du marché de l'apprentissage profond passe de la production de modèles à l'exécution de systèmes agentiques qui réalisent des tâches en plusieurs étapes avec une supervision limitée. L'Index AI de Stanford a suivi une amélioration constante des benchmarks de raisonnement et d'utilisation d'outils, et les déploiements en entreprise suivent [1]. Le succès sera mesuré en tâches complétées plutôt qu'en pourcentages de précision, ce qui modifie à la fois les critères d'acquisition et l'économie des fournisseurs.

Économie des plateformes et consolidation verticale

La marge se déplace vers celui qui contrôle l'ensemble de la pile. Les fournisseurs qui regroupent silicium, mise en réseau, logiciels d'orchestration et accès aux modèles peuvent fixer les prix en fonction des résultats plutôt que des composants — un schéma visible dans l'expansion des portefeuilles logiciels des fournisseurs d'accélérateurs [2][19]. Attendez-vous à ce que les entreprises d'outils indépendants soient acquises ou pressées, avec une défense résidant dans des données propriétaires ou une certification dans des industries réglementées.

La contrainte énergétique devient une stratégie énergétique

L'approvisionnement en énergie est désormais une compétence clé. L'AIE prévoit une croissance continue de la demande d'électricité des centres de données au cours de la décennie, et les opérateurs ont répondu par des contrats nucléaires directs et renouvelables [6]. Les entreprises incapables de sécuriser un approvisionnement ferme et à faible émission de carbone feront face à des désavantages de coût et à une exposition à la divulgation, en particulier sous les règles de reporting européennes.

L'infrastructure de gouvernance mûrit

L'assurance devient un marché à part entière. À mesure que les obligations à haut risque de la loi sur l'IA entrent en vigueur et que le cadre du NIST informe l'acquisition aux États-Unis, l'évaluation par des tiers, les tests d'intrusion et les services de surveillance continue deviendront des éléments standard [3][4]. Les acheteurs sur le marché de l'apprentissage profond devraient s'attendre à ce que la gouvernance représente une part significative du coût total du programme d'ici le début des années 2030.


Analyse de la part de marché régionale

Région Métrique Thèmes d'investissement principaux
Amérique du Nord 38,5 % de part Capacité hyperscale, développement de modèles de frontière, applications de défense
Europe 9,99 milliards USD (2025) Outils de conformité réglementaire, IA industrielle, cloud souverain
Asie-Pacifique 37,4 % TCAC Missions de calcul nationales, automatisation de la fabrication, inférence mobile
Amérique du Sud 4,2 % de part Fintech, agritech, zones cloud régionales
Moyen-Orient & Afrique 34,8 % TCAC Programmes d'IA souverains, centres de données adjacents à l'énergie
Total 45,4 milliards USD (2025) —

La distribution géographique sur le marché de l'apprentissage profond suit trois variables : accès aux accélérateurs, disponibilité de l'électricité et prévisibilité réglementaire. Les régions qui détiennent les trois attirent un déploiement disproportionné.


Amérique du Nord

Pays Part de la région Moteur clé
États-Unis 87,4 % Concentration des dépenses en capital des hyperscalers et recherche sur les modèles de frontière
Canada 8,1 % Densité des instituts de recherche et centres de données alimentés par hydroélectricité
Mexique 4,5 % Analyse de fabrication liée au nearshoring


La politique fédérale a changé de direction en janvier 2025, lorsque l'Ordre Exécutif 14179 a remplacé l'Ordre Exécutif 14110 de l'administration précédente, réorientant l'accent de la déclaration de sécurité vers l'accélération et la compétitivité [5]. Le capital, quant à lui, a évolué indépendamment de la politique : le projet d'infrastructure Stargate annoncé en janvier 2025 par OpenAI, Oracle et SoftBank a ciblé des investissements à une échelle précédemment réservée aux mégaprojets énergétiques [1]. L'avantage du Canada est plus prosaïque : le Québec et le Manitoba offrent une abondance d'énergie à faible émission de carbone à des prix stables, ce qui détermine de plus en plus les décisions d'implantation.

Europe

Pays Part de la région Moteur clé
Allemagne 24,6 % Automatisation industrielle et empilements de perception automobile
Royaume-Uni 19,8 % Modélisation des services financiers et expansion du calcul souverain
France 14,2 % Champions de l'IA soutenus par l'État et centres de données alimentés par nucléaire
Italie 8,7 % Inspection de la qualité de fabrication
Espagne 7,4 % Implantation de centres de données adjacents aux énergies renouvelables
Pays nordiques 9,6 % Avantage en hydroélectricité à faible coût et en refroidissement
Russie 4,1 % Substitution de plateforme domestique
Reste de l'Europe 11,6 % Adoption d'entreprise distribuée


La caractéristique distinctive de l'Europe est que la conformité est arrivée avant l'échelle. Le cadre de risque par niveaux de la Loi sur l'IA oblige les fournisseurs de modèles à usage général à maintenir une documentation technique et des résumés de données d'entraînement, avec des pénalités structurées en pourcentage du chiffre d'affaires mondial [3]. Plutôt que de supprimer l'adoption, cela l'a canalisée : les groupes industriels allemands et français ont priorisé des applications à portée étroite et bien documentées dans l'inspection de la qualité et la maintenance prédictive, où les coûts de conformité sont maîtrisables et les retours mesurables. Le plan d'action du Royaume-Uni de janvier 2025 s'est engagé à augmenter par vingt fois la capacité de calcul public d'ici 2030 [14].

Asie-Pacifique

Pays Part de la région Moteur clé
Chine 46,3 % Programme national d'IA et développement d'accélérateurs domestiques
Inde 14,8 % Installation de calcul de la mission IndiaAI et capacité de services informatiques
Japon 13,1 % Intégration de la robotique et cadre de la Loi de base sur l'IA
Corée du Sud 10,4 % Fabrication de mémoire et inférence sur appareil
ASEAN 9,2 % Développement de zones cloud régionales
Reste de l'Asie-Pacifique 6,2 % Adoption d'entreprise distribuée


L'Asie-Pacifique est le moteur de croissance du marché de l'apprentissage profond moteur, et la raison en est la continuité des politiques plutôt qu'une seule percée. Le Plan de développement de l'IA de nouvelle génération de la Chine a fourni un cadre cible stable depuis 2017, avec une mise en œuvre provinciale fournissant terre, énergie et capital . La sortie de DeepSeek-R1 en janvier 2025 a démontré que des modèles de raisonnement compétitifs pouvaient être entraînés sous un accès limité aux accélérateurs, ce qui a modifié les hypothèses sur la relation entre l'intensité du capital et la capacité [1]. Le Japon a adopté une législation sur l'IA en 2025 mettant l'accent sur la promotion plutôt que sur l'interdiction, et la Loi de base sur l'IA de la Corée du Sud a pris une posture similaire [22]. L'installation de GPU partagée de l'Inde répond directement au problème d'accès pour les startups exclues des contrats hyperscale [13].

Amérique du Sud

Pays Part de la région Moteur clé
Brésil 61,8 % Détection de fraude fintech et modélisation des rendements agricoles
Argentine 16,4 % Services d'exportation de logiciels
Reste de l'Amérique du Sud 21,8 % Optimisation du commerce de détail et de la logistique


Le cadre proposé pour l'IA du Brésil, avancé par le Sénat sous le PL 2338/2023, établirait le régime de gouvernance le plus complet de la région et a déjà influencé le langage d'approvisionnement des entreprises [23]. L'adoption se concentre dans les services financiers, où les volumes de paiements instantanés via le système Pix génèrent des données de transaction à une échelle qui justifie une infrastructure de modèle dédiée. Les applications agricoles — prévisions de rendement, détection de maladies à partir d'images — représentent le deuxième cluster, soutenu par des recherches financées par des coopératives.

Moyen-Orient & Afrique

Pays Part de la région Moteur clé
Arabie Saoudite 34,2 % Stratégie nationale SDAIA et diversification Vision 2030
Émirats Arabes Unis 29,6 % Stratégie nationale d'IA 2031 et développement de modèles souverains
Afrique du Sud 13,8 % Analyse des services financiers et des mines
Égypte 8,9 % Numérisation du secteur public
Reste du MEA 13,5 % Optimisation des réseaux de télécommunications


Les États du Golfe convertissent leur avantage énergétique en avantage de calcul. La SDAIA d'Arabie Saoudite opère en tant qu'autorité centrale avec un budget et un mandat, tandis que les Émirats Arabes Unis ont poursuivi le développement de modèles souverains parallèlement à des investissements dans les infrastructures [16][17]. L'énergie à faible coût et les terres disponibles rendent la région structurellement attractive pour les clusters d'entraînement, bien que les considérations de contrôle des exportations façonnent quels accélérateurs peuvent être déployés et dans quelles conditions. L'adoption en Afrique subsaharienne reste concentrée dans les applications de télécommunications et d'inclusion financière.


Marché de l'apprentissage profond par région, 2025-2035

Deep Learning Market Segmentation

Par offre

Le marché de l'apprentissage profond se divise en matériel, logiciel et services, avec un équilibre qui se déplace progressivement vers le logiciel à mesure que les modèles déployés se développent.

Segment Métrique Principal moteur de la demande
Matériel 55,8 % de part Accélérateur, mémoire et développement de réseau
Logiciel 35,1 % TCAC Orchestration, MLOps et optimisation de l'inférence
Services 6,27 milliards USD (2025) Intégration, opérations gérées et assurance


La domination du matériel reflète une phase de construction, pas une structure permanente. Chaque dollar de capacité d'accélérateur nécessite finalement un logiciel pour le programmer, le surveiller et l'optimiser, et ce ratio s'améliore pour le logiciel à mesure que les clusters vieillissent. La croissance des services est concentrée dans les industries réglementées, où les lacunes de capacité interne et les obligations de documentation combinent pour faire de la livraison externe la norme plutôt que l'exception.

Par application

Le mélange d'applications au sein du marché de l'apprentissage profond s'est considérablement élargi depuis l'inflexion des modèles linguistiques de 2023.

Segment Métrique Principal moteur de la demande
Reconnaissance d'images et de vidéos 32,6 % de part Inspection industrielle, imagerie médicale, surveillance
NLP et Analyse de texte 38,4 % TCAC Assistants d'entreprise et automatisation de documents
Reconnaissance vocale et de la parole 8,35 milliards USD (2025) Automatisation des centres de contact et interfaces en véhicule
Extraction de données 12,7 % de part Détection de fraude et prévision de la demande
Autres 8,4 % de part Recommandation, robotique, calcul scientifique


La reconnaissance d'images et de vidéos conserve la plus grande part car sa base de déploiement précède le cycle actuel — les lignes d'inspection de fabrication et les flux de travail en radiologie s'accumulent depuis la fin des années 2010. L'analyse de texte croît le plus rapidement, et la raison est architecturale : les modèles de transformateurs pour le traitement du langage naturel se généralisent à travers les types de documents avec un minimum d'ingénierie spécifique à la tâche, ce qui réduit le coût d'ajout de chaque nouveau cas d'utilisation.

Par secteur d'utilisateur final

L'adoption sectorielle sur le marché de l'apprentissage profond est étroitement corrélée à la maturité des données et à la tolérance réglementaire.

Segment Métrique Principal moteur de la demande
BFSI 18,6 % de part Détection de fraude, scoring de crédit, automatisation de la conformité
Commerce de détail et E-Commerce 6,90 milliards USD (2025) Personnalisation et planification de la demande
IT et Télécom 14,2 % de part Optimisation du réseau et opérations clients
Fabrication 36,8 % TCAC Inspection visuelle et maintenance prédictive
Santé 12,8 % de part Imagerie diagnostique et documentation clinique
Automobile 39,2 % TCAC Stacks de perception et surveillance des conducteurs
Gouvernement et Défense 8,1 % de part Analyse de renseignement et surveillance des infrastructures
Autres 6,2 % de part Énergie, agriculture, logistique


BFSI est en tête en termes de dépenses absolues car les banques avaient déjà des fonctions de gouvernance des risques modèles avant l'arrivée de l'apprentissage profond — l'échafaudage organisationnel existait. L'automobile croît le plus rapidement à partir d'une base plus petite alors que les systèmes de perception passent de l'assistance au conducteur vers des niveaux d'automatisation plus élevés, chaque programme de véhicule représentant une dépense engagée sur plusieurs années plutôt qu'un pilote discrétionnaire.

Par déploiement

Segment Métrique Principal moteur de la demande
Cloud 68,4 % de part Capacité élastique et accès aux derniers accélérateurs
Sur site 34,2 % TCAC Souveraineté des données, latence et économie unitaire prévisible


Le cloud reste la norme pour le marché de l'apprentissage profond, en particulier pour les pics d'entraînement où posséder une capacité immobiliserait des capitaux. La croissance sur site est néanmoins plus rapide, entraînée par des organisations avec des volumes d'inférence constants qui rendent l'infrastructure possédée moins coûteuse à grande échelle, et par des entités réglementées qui ne peuvent pas exporter des données à travers les juridictions.


Analyse Concurrentielle

La concentration sur le marché de l'apprentissage profond est mieux caractérisée comme moyenne au niveau agrégé mais sévère au sein des couches. La couche d'accélérateurs approche un HHI estimé au-dessus de 5 000, tandis que les logiciels et services restent fragmentés avec des centaines de fournisseurs crédibles. Les cinq principaux participants représentent environ 52 à 58 % des revenus totaux, le reste étant réparti entre des développeurs de silicium spécialisés, des fournisseurs de plateformes et des intégrateurs de systèmes. L'intégration verticale est le comportement stratégique déterminant — les participants s'étendent vers le haut dans les logiciels et vers le bas dans les réseaux simultanément.

Entreprise Plage Estimée de Part de Revenus Offres Clés pour le Marché de l'Apprentissage Profond Positionnement Stratégique
NVIDIA Corporation ~28–33% Accélérateurs GPU, mise en réseau, logiciels AI CUDA et d'entreprise Acteur établi à pleine pile ; le verrouillage logiciel renforce la position en silicium
Microsoft Corporation ~9–12% Infrastructure AI Azure, hébergement de modèles, outils pour développeurs Avantage de distribution d'entreprise grâce à l'infrastructure cloud existante
Alphabet Inc. (Google) ~8–11% Accélérateurs TPU, Vertex AI, modèles de base Seul acteur intégré verticalement avec silicium et modèles internes
Amazon Web Services ~7–10% Silicium Trainium et Inferentia, SageMaker, Bedrock Large éventail de services gérés ; silicium personnalisé réduit l'exposition aux coûts
Intel Corporation ~4–6% Accélérateurs Gaudi, inférence CPU, boîte à outils OpenVINO Concurrence sur le coût total et les logiciels ouverts plutôt que sur la performance maximale
Advanced Micro Devices ~3–5% Accélérateurs Instinct, pile logicielle ROCm Alternative crédible de seconde source ; positionnement en open-stack
Meta Platforms ~3–5% Modèles à poids ouverts, silicium d'inférence MTIA, gestion de PyTorch Influence de l'écosystème par le biais de publications ouvertes plutôt que de monétisation directe
IBM Corporation ~2–4% Plateforme watsonx, déploiement hybride, outils de gouvernance Spécialiste des industries réglementées avec un accent sur l'assurance
Qualcomm Incorporated ~2–3% Processeurs d'inférence Edge et mobiles, AI Engine Leadership en inférence sur appareil dans le mobile et l'automobile
Baidu, Inc. ~2–3% Accélérateurs Kunlun, cadre PaddlePaddle, modèles ERNIE Alternative complète domestique chinoise
Samsung Electronics ~1–3% Mémoire à large bande, processeurs sur appareil Leverage de la chaîne d'approvisionnement grâce à la position mémoire


Actualités récentes & Développements

  • NIST (janvier 2023) : Publication du Cadre de Gestion des Risques liés à l'IA 1.0, offrant aux entreprises américaines un vocabulaire de contrôle commun qui a depuis été référencé dans les spécifications d'approvisionnement à travers les secteurs réglementés [4]
  • Advanced Micro Devices (décembre 2023) : Lancement de l'accélérateur Instinct MI300X, établissant une seconde source crédible pour les charges de travail d'entraînement à haute mémoire et atténuant les préoccupations liées à la dépendance à un seul fournisseur parmi les grands acheteurs [19]
  • NVIDIA Corporation (mars 2024) : Annonce de l'architecture Blackwell et du système rack-scale GB200 NVL72 lors de GTC, visant une efficacité d'inférence considérablement améliorée pour les modèles à un trillion de paramètres — la plateforme de référence pour le cycle de construction actuel [2]
  • Gouvernement de l'Inde (mars 2024) : Le Cabinet de l'Union a approuvé la Mission IndiaAI avec un budget d'environ ₹10,372 crores, y compris une installation de calcul GPU partagée destinée à élargir l'accès au-delà des grandes entreprises [13]
  • Meta Platforms (avril & juillet 2024) : Publication de Llama 3 et par la suite du Llama 3.1 à 405 milliards de paramètres sous une licence à poids ouverts, abaissant considérablement la barrière pour les entreprises poursuivant un déploiement auto-hébergé [21]
  • Union Européenne (août 2024) : Le règlement (UE) 2024/1689 est entré en vigueur, avec des obligations pour les modèles d'IA à usage général s'appliquant à partir d'août 2025 — le premier régime de conformité extraterritorial contraignant pour le secteur [3]
  • OpenAI, Oracle et SoftBank (janvier 2025) : Annonce de la coentreprise Stargate pour le développement de centres de données IA à grande échelle aux États-Unis, signalant que le financement des infrastructures était passé à une échelle de financement de projet [1]
  • DeepSeek (janvier 2025) : Publication du modèle de raisonnement R1, démontrant une capacité compétitive atteinte sous un accès contraint aux accélérateurs et incitant à une large réévaluation de l'intensité capitalistique requise pour des performances de pointe [1]


Marché de l'apprentissage profond Market Report Scope

Paramètre Détail
Portée du marché Marché mondial de l'apprentissage profond couvrant le matériel, les logiciels et les services dans tous les secteurs d'utilisateurs finaux et modes de déploiement
Période d'étude 2021–2035 (Historique 2021–2024; Année de base 2025; Prévisions 2026–2035)
CAGR 33,0 % (2026–2035)
Points de contrôle de la taille du marché 45,4 milliards USD (2025); 60,4 milliards USD (2026); 189,0 milliards USD (2030); 786,5 milliards USD (2035)
Segments à la croissance la plus rapide Automobile (utilisateur final); NLP et analyse de texte (application); Logiciel (offre); Asie-Pacifique (région)
Entreprises profilées NVIDIA, Microsoft, Alphabet, Amazon Web Services, Intel, AMD, Meta Platforms, IBM, Qualcomm, Baidu, Samsung Electronics
Devise d'évaluation USD, prix constants de 2025

FAQ

Comment un acheteur devrait-il structurer un contrat d'approvisionnement pour l'infrastructure du marché de l'apprentissage profond compte tenu de l'obsolescence rapide du matériel ?
Négociez des engagements de capacité avec des clauses de renouvellement plutôt que des SKU matériels fixes. Des termes de trois ans avec des droits de mise à niveau à mi-parcours préservent l'accès à de nouveaux accélérateurs sans immobiliser de capital. Ancrez les prix au débit fourni, et non aux unités installées [11].
Qu'est-ce qui distingue une architecture de mélange d'experts d'un modèle dense dans l'économie de production ?
Le mélange d'experts active uniquement un sous-ensemble de paramètres par jeton, réduisant considérablement le coût d'inférence tout en maintenant une qualité comparable. Le compromis est une empreinte mémoire plus élevée et une infrastructure de service plus complexe. Les modèles denses restent plus simples à déployer à plus petite échelle [1].
Quelles questions d'assurance et de responsabilité les équipes juridiques devraient-elles soulever avant le déploiement du marché de l'apprentissage profond ?
Clarifiez l'allocation de la responsabilité pour les résultats du modèle entre le fournisseur et le déployeur, et confirmez si la couverture existante des erreurs et omissions technologiques s'étend aux décisions autonomes. Les classifications à haut risque en Europe peuvent déclencher des obligations supplémentaires indépendamment des termes du contrat [3].
Les données d'entraînement synthétiques sont-elles un substitut viable lorsque les données du monde réel sont rares ou restreintes ?
Les données synthétiques fonctionnent bien pour augmenter les classes rares et couvrir les cas limites dans les tâches de perception. Elles dégradent les performances lorsqu'elles sont utilisées comme source principale, produisant des modèles qui échouent face à un véritable changement de distribution. Considérez-les comme un complément, pas un remplacement [1].
Comment les contrôles à l'exportation affectent-ils la planification du déploiement multinational du marché de l'apprentissage profond ?
Les restrictions à l'exportation des accélérateurs varient selon la destination et peuvent changer avec un préavis limité. Les multinationales devraient concevoir la portabilité des charges de travail à travers les architectures et maintenir une redondance de capacité régionale. Un examen juridique des transferts de poids de modèle transfrontaliers devient de plus en plus nécessaire .
Quel est le calendrier d'intégration réaliste pour connecter des modèles à des systèmes d'entreprise hérités ?
Attendez-vous à neuf à dix-huit mois pour les environnements réglementés. L'extraction de données et la remédiation de la qualité consomment la majeure partie de ce temps, et non le travail sur le modèle. Les organisations disposant de plateformes de données existantes compressent cela considérablement [25].
Les organisations devraient-elles développer une capacité d'évaluation interne ou l'externaliser ?
Développez une capacité interne pour des critères de qualité spécifiques au domaine que les fournisseurs externes ne peuvent pas juger. Externalisez les tests adversariaux et les équipes de sécurité, où l'expertise spécialisée et l'indépendance sont importantes. Les arrangements hybrides deviennent la norme dans les services financiers [4].
Auteur
Auteur Author Profile Nirmit Biswas LinkedIn Senior Research Analyst
With 5+ years of expertise in Market Intelligence and Strategic Research, Nirmit Biswas specializes in ICT, Semiconductors, and BFSI. Backed by an MBA in Financial Services and a Computer Science foundation, Nirmit blends technical depth with business acumen. He has successfully led 100+ projects for global enterprises and startups, including Amazon, Cisco, L&T and Huawei, delivering market estimations, competitive benchmarking, and GTM strategies. His focus lies in transforming complex data into clear, actionable insights that drive growth, innovation, and investment decisions. Recognized for bridging engineering innovation with executive strategy, Nirmit helps businesses navigate dynamic markets with confidence.
Co-auteur Co-Author Profile Aarti Dhapte LinkedIn AVP - Research
A consulting professional focused on helping businesses navigate complex markets through structured research and strategic insights. I partner with clients to solve high-impact business problems across market entry strategy, competitive intelligence, and opportunity assessment. Over the course of my experience, I have led and contributed to 100+ market research and consulting engagements, delivering insights across multiple industries and geographies, and supporting strategic decisions linked to $500M+ market opportunities. My core expertise lies in building robust market sizing, forecasting, and commercial models (top-down and bottom-up), alongside deep-dive competitive and industry analysis. I have played a key role in shaping go-to-market strategies, investment cases, and growth roadmaps, enabling clients to make confident, data-backed decisions in dynamic markets.

Research Approach


Secondary Research

The secondary research process involved comprehensive analysis of AI regulatory frameworks, peer-reviewed computer science journals, machine learning conferences, and authoritative technology organizations. Key sources included the National Institute of Standards and Technology (NIST AI Risk Management Framework), National Science Foundation (NSF) AI Research Institutes, European Commission AI Act and AI Watch, IEEE Standards Association (AI Ethics & Standards), Association for Computing Machinery (ACM) Digital Library, International Organization for Standardization (ISO/IEC JTC 1/SC 42 - Artificial Intelligence), Partnership on AI, World Economic Forum (WEF) Global AI Council, MIT Technology Review, arXiv.org (Computer Science & Machine Learning), Google Scholar (NeurIPS, ICML, CVPR Proceedings), MRFR Hype Cycle for Artificial Intelligence, MRFR Worldwide Semiannual Artificial Intelligence Tracker, OECD.AI Policy Observatory, China's Ministry of Science and Technology (AI Development Plan), UK AI Council, MRFR Global Institute (AI & Automation Reports), and government AI readiness indices from key markets.

The following sources were employed to gather data on algorithm advancement, regulatory compliance frameworks, compute infrastructure statistics, enterprise adoption trends, patent landscaping, and technology readiness levels for deep neural networks, convolutional neural networks, and recurrent neural network architectures in cloud-based, on-premises, and hybrid deployment environments.


Primary Research

Qualitative and quantitative insights were obtained by interviewing supply-side and demand-side stakeholders during the primary research process. From semiconductor manufacturers (Intel, AMD), AI software development firms, and deep learning platform providers (NVIDIA, Google Cloud AI, Microsoft Azure AI, AWS), supply-side sources included CTOs, Chief AI Officers, VPs of Machine Learning Engineering, Research Scientists, Product Heads, and Cloud Infrastructure Directors. Chief Data Officers, Heads of AI/ML, Data Science Directors, Algorithm Engineers, and Digital Transformation were the demand-side sources. Leads from healthcare institutions (diagnostic imaging centers, pharmaceutical R&D), automotive OEMs (autonomous driving divisions), financial services (algorithmic trading, risk management), and retail enterprises (recommendation engine teams). Confirmation of AI accelerator hardware roadmaps, validation of market segmentation across image recognition and natural language processing applications, and acquisition of insights regarding model training costs, inference latency requirements, data privacy compliance, and cloud versus on-premises deployment decision drivers were all achieved through primary research.

Primary Respondent Breakdown:

By Designation: C-level Primaries (32%), Director Level (30%), Others (38%)

By Region: North America (38%), Europe (25%), Asia-Pacific (28%), Rest of World (9%)


Market Size Estimation

Revenue mapping and compute infrastructure analysis were employed to determine global market valuation. The methodology comprised the following:

Identification of over 55 significant technology providers in North America, Europe, Asia-Pacific, and the Middle East and Africa

Product mapping across transformer architectures, convolutional neural networks (CNN), recurrent neural networks (RNN), and deep neural networks (DNN)

Deployment mode analysis includes hybrid edge computing configurations, on-premises (enterprise data centers), and cloud-based (AWS, Azure, GCP).

End-use industry coverage includes healthcare (diagnostic imaging, drug discovery), automotive (autonomous systems, ADAS), financial services (fraud detection, algorithmic trading), and retail (visual search, recommendation systems).

An examination of the annual revenues of deep learning software frameworks, AI accelerator processors (GPUs, TPUs, FPGAs), and cloud AI services, as reported and modeled.

In 2024, the coverage of technology providers will account for 75-80% of the global market share.

Derive segment-specific valuations for image recognition, natural language processing, speech recognition, and recommendation system applications through extrapolation using bottom-up (enterprise AI spend × deployment penetration by sector) and top-down (vendor revenue validation across cloud AI services and on-premise software licenses) approaches.

Télécharger l'échantillon gratuit

Veuillez remplir le formulaire ci-dessous pour recevoir un échantillon gratuit de ce rapport

Global Diameter Signaling Market
Étude de cas
Information and Communications Technology
Download PDF ×

We do not share your information with anyone. However, we may send you emails based on your report interest from time to time. You may contact us at any time to opt-out.



















