Data Masking Market (2026 – 2035)

Tamaño del Mercado de Enmascaramiento de Datos, Participación e Informe de Investigación por Componente (Servicios, Software, Servicios Gestionados, Servicios Profesionales), por Función Empresarial (Ventas y Marketing, Recursos Humanos, Finanzas Legales, Operaciones), por Tipo (Enmascaramiento de Datos Dinámico, Enmascaramiento de Datos Estático) y por Región (América del Norte, Europa, Asia-Pacífico, Resto del Mundo) - Pronóstico de la Industria hasta 2035.
ID: MRFR/ICT/4039-HCR 100 Pages Ankit Gupta, Aarti Dhapte Last Updated: September 15, 2026
Data Masking Market
Market Size
Forecast Period2026-2035
CAGR (2026-2035)13.28%
2025 Market SizeUSD 1.24 Billion
2035 Market SizeUSD 4.48 Billion
Key Players
IBM Corporation
Oracle Corporation
Informatica Inc.
Delphix
Broadcom
Microsoft Corporation
Opportunities
  • Synthetic Data Generation Convergence
  • Confidential Computing Integration
  • Emerging Market Regulatory Catalysts

Data Masking Market Summary

El mercado de enmascaramiento de datos alcanzó una valoración de 1.24 mil millones de USD en 2025 y se proyecta que crecerá de 1.42 mil millones de USD en 2026 a 4.48 mil millones de USD para 2035, registrando una CAGR del 13.28% durante el período de pronóstico (2026–2035). El endurecimiento de los mandatos de privacidad de datos —incluyendo la Ley de Resiliencia Operativa Digital de la UE (DORA) y las disposiciones actualizadas de aplicación de la CCPA de California— está obligando a las empresas a formalizar técnicas de ofuscación de datos sensibles en entornos de producción y no producción [2]. Al mismo tiempo, un aumento del 72% año tras año en el ransomware dirigido a activos de bases de datos hasta 2024 ha acelerado la adquisición de tokenización para la protección de datos PII y enmascaramiento de datos estáticos y dinámicos para entornos de prueba [3].

Un cambio tecnológico pronunciado está en marcha a medida que las organizaciones retiran rutinas de anonimización heredadas basadas en scripts a favor de plataformas de enmascaramiento potenciadas por IA capaces de descubrir automáticamente campos sensibles y realizar transformaciones que preservan el formato. MRFR estima que el gasto empresarial en anonimización de datos para herramientas de cumplimiento del GDPR superó los 2.1 mil millones de USD a nivel mundial en 2024, reflejando un giro decisivo hacia suites de enmascaramiento integradas que sirven simultáneamente a tuberías de DevOps y cargas de trabajo de análisis. El enmascaramiento de bases de datos para entornos no productivos es ahora una expectativa básica para los flujos de trabajo de CI/CD, reemplazando prácticas ad-hoc de subconjuntos de datos que introducían riesgos de cumplimiento.

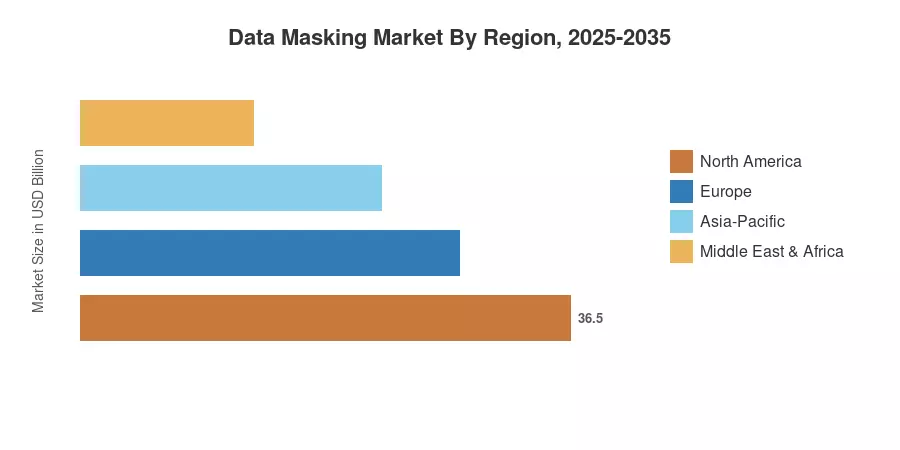
América del Norte ocupó aproximadamente el 34% de la cuota del mercado de enmascaramiento de datos en 2025, anclada por la estricta aplicación de HIPAA y SOX y un ecosistema de servicios en la nube maduro. Asia-Pacífico es la región de más rápido crecimiento con una CAGR proyectada del 14.22% hasta 2035, impulsada por la Ley de Protección de Datos Personales Digitales de India (2023) y las regulaciones de transferencia de datos transfronterizos en expansión de China [5]. Europa representa el segundo bloque regional más grande, donde las escalaciones de multas del GDPR continúan impulsando la adopción de anonimización de datos para soluciones de cumplimiento del GDPR en los sectores de servicios financieros y salud. El mercado de enmascaramiento de datos está preparado para una expansión sostenida de dos dígitos a medida que las arquitecturas de nube híbrida y el análisis en tiempo real empujan el enmascaramiento más profundamente en las pilas de datos empresariales.

Principales Conclusiones del Informe

• Por Tipo

  • El enmascaramiento estático capturó el 53.21% de la cuota de ingresos del mercado de enmascaramiento de datos en 2025, reflejando su dominio en el enmascaramiento de bases de datos orientado a lotes para entornos no productivos
  • El enmascaramiento dinámico está destinado a expandirse a una CAGR del 13.68% hasta 2035, impulsado por la demanda de tokenización en tiempo real para la protección de datos PII en aplicaciones orientadas al cliente

• Por Modelo de Implementación

  • Las instalaciones locales representaron el 50.87% del mercado de enmascaramiento de datos en 2025, favorecidas por industrias reguladas que requieren control de residencia de datos
  • Las implementaciones en la nube están creciendo a una CAGR del 13.91% hasta 2035 a medida que las plataformas de enmascaramiento nativas de SaaS ganan tracción

• Por Tamaño de Organización

  • Las grandes empresas dominaron el 63.48% de los ingresos del mercado en 2025, invirtiendo fuertemente en técnicas de ofuscación de datos sensibles en propiedades de datos distribuidos
  • Las PYME registran la perspectiva de crecimiento más rápida con una CAGR del 13.82% hasta 2035

• Por Industria de Usuario Final

  • BFSI capturó 0.33 mil millones de USD en 2025, reflejando mandatos de cumplimiento rigurosos para el enmascaramiento de datos estáticos y dinámicos para entornos de prueba
  • La salud avanza a una CAGR del 14.08% hasta 2035, impulsada por los requisitos de enmascaramiento de registros de salud electrónicos (EHR)

• Por Región

  • América del Norte lideró el mercado de enmascaramiento de datos con aproximadamente el 34% de participación en 2025
  • Asia-Pacífico está destinada a crecer a una CAGR del 14.22% hasta 2035, liderada por la modernización regulatoria en India, China y las naciones de ASEAN

El dimensionamiento del mercado de MRFR integra un análisis de ingresos de proveedores de abajo hacia arriba, encuestas de adquisición de usuarios finales en 22 países y modelado macroeconómico de arriba hacia abajo, comparado con índices de gasto en seguridad de TI. Las cifras históricas (2021–2024) están calibradas a los presupuestos reportados de protección de datos empresariales, mientras que el pronóstico (2026–2035) aplica un modelo compuesto ajustado por cadencia regulatoria, velocidad de migración a la nube y curvas de sustitución tecnológica[6].
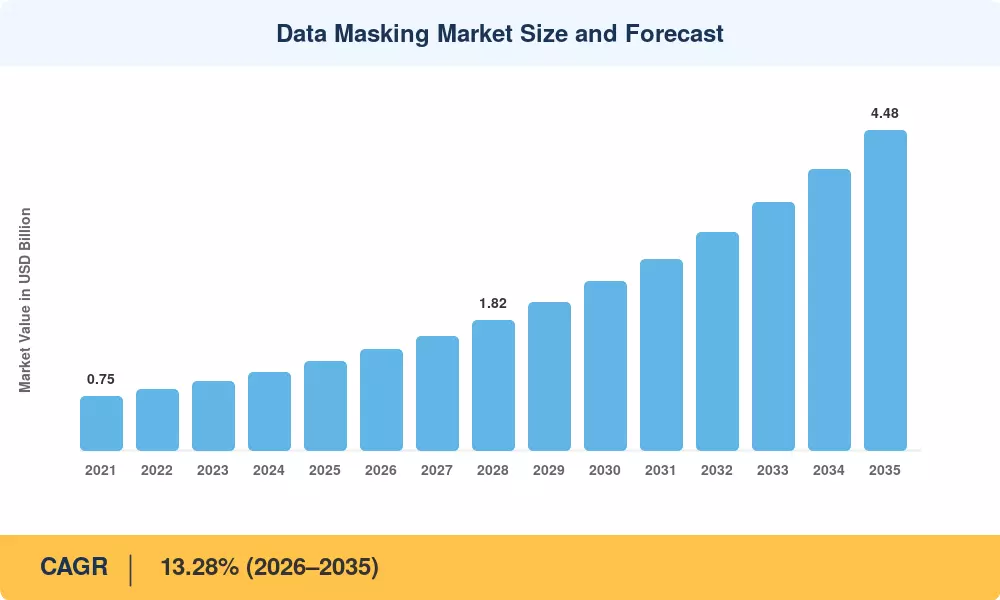
Tamaño y Pronóstico del Mercado de Enmascaramiento de Datos
Our Impact

Enabled $4.3B Revenue Impact for Fortune 500 and Leading Multinationals

Partnering with 2000+ Global Organizations Each Year

30K+ Citations by Top-Tier Firms in the Industry

Análisis del Impacto del Conductor

Conductor ~% Impacto en CAGR Relevancia Geográfica Línea de Tiempo del Impacto
Regulaciones de privacidad de datos en aumento ~22% Global Corto plazo (≤2 años)
Migración a la nube y arquitecturas de nube híbrida ~19% América del Norte, Europa Mediano plazo (2–4 años)
Escalación de costos por ransomware y brechas ~16% Global Corto plazo (≤2 años)
Descubrimiento de campos sensibles aumentado por IA ~14% América del Norte, Asia-Pacífico Mediano plazo (2–4 años)
Requisitos de datos de prueba de DevOps/CI-CD ~12% Global Corto plazo (≤2 años)
Expansión en el enmascaramiento de datos no estructurados ~10% Europa, Asia-Pacífico Largo plazo (≥4 años)
Plataformas de enmascaramiento SaaS enfocadas en PYMEs ~7% Asia-Pacífico, América del Sur Largo plazo (≥4 años)

Regulaciones de Privacidad de Datos en Aumento

Desde 2021, la superficie regulatoria relacionada con la protección de datos ha crecido significativamente. Para el tercer trimestre de 2024, los procedimientos de aplicación del GDPR habían resultado en multas acumuladas de 4.5 mil millones de EUR, y entre 2023 y 2025, 14 estados en los Estados Unidos aprobaron leyes de privacidad integrales [2]. La anonimización de datos para el cumplimiento del GDPR se ha convertido esencialmente de una inversión voluntaria en un requisito de cumplimiento con cada nueva regla. Se está creando un bucle de ROI medible que mantiene el impulso de adquisición en todo el mercado de enmascaramiento de datos, utilizando organizaciones la tokenización para la protección de datos PII y el enmascaramiento de datos estático y dinámico para entornos de prueba, citando reducciones del 40–60% en las duraciones de remediación de auditoría [2].

Migración a la Nube y Arquitecturas de Nube Híbrida

Las cargas de trabajo empresariales que se ejecutan en entornos de nube pública cruzaron el 55% de penetración en 2024, según el informe del Estado de la Nube de Flexera [6]. Este cambio fragmenta los patrimonios de datos a través de AWS, Azure y GCP, multiplicando la superficie de ataque e intensificando la demanda de enmascaramiento de bases de datos nativas de la nube para entornos no productivos. Los proveedores de enmascaramiento que ofrecen orquestación multi-nube y API-first están capturando una parte desproporcionada dentro del Mercado de Enmascaramiento de Datos, particularmente entre las instituciones financieras que gestionan implementaciones multi-regionales bajo regímenes de cumplimiento superpuestos [6][12].

Escalación de Costos por Ransomware y Brechas

Según el Informe sobre el Costo de una Brecha de Datos 2024 de IBM, el costo promedio de una brecha aumentó un 10% año tras año a 4.88 millones de USD [3]. El argumento comercial para el enmascaramiento como un control preventivo en lugar de un gasto de limpieza posterior al incidente se fortalece por el hecho de que las organizaciones que han adoptado técnicas de ofuscación de datos sensibles en bases de datos no productivas tuvieron costos de brechas un 27% inferiores a la norma global [3].

Descubrimiento de Campos Sensibles Aumentado por IA

Los clasificadores de aprendizaje automático ahora logran una precisión del 94–97% en la identificación de campos PII, PHI y PCI en repositorios estructurados y semi-estructurados, reduciendo el esfuerzo de catalogación manual de datos en un 70% estimado [7]. Esta capacidad acelera el tiempo de enmascaramiento de semanas a horas y está remodelando la dinámica competitiva dentro del Mercado de Enmascaramiento de Datos a medida que los proveedores compiten por integrar copilotos de IA generativa en los flujos de trabajo de enmascaramiento [7][9].

Análisis del Impacto de las Restricciones

Restricción ~% Impacto Negativo en CAGR Segmentos Afectados Principales Línea de Tiempo del Impacto
Complejidad de implementación para sistemas heredados ~–18% Grandes empresas, en las instalaciones Corto plazo (2–4 años)
Barreras de costo de licencia para PYMEs ~–15% PYMEs, mercados emergentes Corto plazo (≤2 años)
Preocupaciones sobre la degradación de la utilidad de los datos ~–14% Salud, verticales con alta analítica Corto plazo (2–4 años)
Escasez de ingenieros de enmascaramiento especializados ~–12% Global Largo plazo (≥4 años)
Brechas de interoperabilidad en entornos multi-nube ~–10% Despliegues en la nube, BFSI Corto plazo (2–4 años)

Complejidad de Implementación para Sistemas Legados

Las grandes empresas que operan entornos ERP en mainframe o en las instalaciones enfrentan ciclos de despliegue de 6 a 12 meses para programas de enmascaramiento integrales, con costos de integración que a menudo superan la licencia inicial en 2 a 3 veces. Estos plazos limitan la velocidad a la que las organizaciones pueden extender las técnicas de ofuscación de datos sensibles a todos los repositorios de datos, creando un patrón de adopción por fases que modera el crecimiento a corto plazo en el Mercado de Enmascaramiento de Datos.

Barreras de Costo de Licencia para PYMEs

Las licencias típicas de plataformas de enmascaramiento empresarial oscilan entre 80,000 y 350,000 USD anuales, lo que coloca soluciones completas fuera del alcance de las PYMEs con presupuestos de TI limitados. Aunque están surgiendo modelos de precios SaaS, muchos carecen de los controles granulares requeridos para el enmascaramiento de bases de datos en entornos no productivos en industrias reguladas, limitando su aplicabilidad.

Preocupaciones sobre la Degradación de la Utilidad de los Datos

Los conjuntos de datos enmascarados que no logran preservar las distribuciones estadísticas o la integridad referencial socavan la analítica posterior y el entrenamiento de modelos de aprendizaje automático [17]. Las empresas de salud y servicios financieros informan que las transformaciones de enmascaramiento mal configuradas pueden reducir la precisión del modelo en un 12 a 18%, creando resistencia entre los equipos de ciencia de datos y ralentizando los despliegues a nivel empresarial de la anonimización de datos para las herramientas de cumplimiento de GDPR.

Data Masking Market Opportunities

Convergencia en la Generación de Datos Sintéticos

La intersección de la enmascaramiento de datos y la generación de datos sintéticos representa una oportunidad direccionable de 900 millones de USD para 2030 [9]. Las organizaciones que combinan la tokenización para la protección de datos PII con la augmentación sintética pueden producir conjuntos de datos seguros para la privacidad que coinciden con perfiles estadísticos de calidad de producción — una propuesta atractiva para los pipelines de entrenamiento de IA/ML

Integración de Computación Confidencial

Los entornos de ejecución confiables (TEE) basados en hardware de Intel, AMD y ARM están creando un mercado complementario para la orquestación de enmascaramiento en reposo y en uso. Los proveedores que integran técnicas de ofuscación de datos sensibles con marcos de computación confidencial pueden desbloquear nuevas fuentes de ingresos en escenarios de compartición de datos entre múltiples partes, particularmente en I+D farmacéutica y análisis de fraude financiero

Catalizadores Regulatorios en Mercados Emergentes

La Ley DPDP de India, la expansión de la aplicación de la LGPD de Brasil y la PDPL de Arabia Saudita cubren colectivamente a 2.8 mil millones de personas bajo regímenes modernos de protección de datos [5][12]. Estos mercados representan territorio virgen para el Mercado de Enmascaramiento de Datos, donde los proveedores de enmascaramiento pioneros con plantillas de cumplimiento localizadas pueden capturar una parte desproporcionada

Enmascaramiento como Servicio para Empresas de Mercado Medio

Un modelo de servicio de enmascaramiento impulsado por API y pagado por uso podría reducir las barreras de adopción para las 4.2 millones de empresas de mercado medio a nivel global que actualmente carecen de cualquier programa formal de enmascaramiento de datos. El enmascaramiento de datos estático y dinámico nativo de la nube para entornos de prueba entregado a través de precios por consumo puede acelerar la penetración en verticales desatendidos como educación, hospitalidad y comercio minorista

Expansión de la Protección de Datos No Estructurados

Solo el 18% de las empresas actualmente aplican enmascaramiento a los almacenes de datos no estructurados — documentos, correos electrónicos, imágenes y registros de chat — a pesar de que estos repositorios contienen un estimado del 35–40% de información sensible [11]. Los motores de enmascaramiento impulsados por NLP y visión por computadora representan una frontera de alto crecimiento para el Mercado de Enmascaramiento de Datos hasta 2035

Data Masking Market Future Outlook

Plataformas de Enmascaramiento Nativas de IA

Para 2030, se estima que el 65% de los despliegues de enmascaramiento empresarial incorporarán copilotos de IA generativa que clasifiquen de manera autónoma los campos sensibles, recomienden políticas de enmascaramiento y validen la utilidad de los datos después de la transformación [7][9]. El mercado de enmascaramiento de datos pasará de un enmascaramiento basado en reglas a uno basado en intenciones, donde las definiciones de políticas en lenguaje natural reemplazarán las configuraciones manuales de regex.

Ecosistema de Computación que Mejora la Privacidad

La convergencia de la tokenización para la protección de datos PII, la encriptación homomórfica y la computación segura multiparte creará una pila integrada de computación que mejora la privacidad (PEC) a principios de la década de 2030. MRFR proyecta que el gasto en PEC alcanzará los 8 mil millones de dólares a nivel mundial para 2032, con el enmascaramiento de datos sirviendo como la capa fundamental para la protección de datos en uso y en reposo dentro de esta pila[14].

Convergencia Regulatoria y Estándares de Interoperabilidad

ISO/IEC 27559 (control de divulgación estadística) y los estándares emergentes de IEEE para la desidentificación probablemente establecerán un vocabulario técnico común para las técnicas de ofuscación de datos sensibles para 2028 . El mercado de enmascaramiento de datos se beneficiará a medida que los marcos estandarizados reduzcan las preocupaciones sobre el bloqueo de proveedores y aceleren las decisiones de adquisición transfronterizas.

Enmascaramiento Integrado en DevSecOps

Enmascaramiento como código — donde las políticas de enmascaramiento están controladas por versiones, revisadas por pares y desplegadas a través de pipelines de CI/CD — se convertirá en el paradigma predeterminado para el enmascaramiento de datos estáticos y dinámicos para entornos de prueba para 2029 [13]. Este cambio integra el enmascaramiento dentro del ciclo de vida del desarrollo de software en lugar de tratarlo como una idea secundaria, comprimiendo los ciclos de cumplimiento y reduciendo el costo del enmascaramiento de bases de datos para entornos no productivos en un estimado del 30–40% [13][18].

Análisis de Participación de Mercado Regional

Región Métrica Clave Temas de Inversión Primarios
América del Norte ~34% de participación (2025) Cumplimiento de HIPAA/SOX, enmascaramiento nativo en la nube, datos de pruebas de DevOps
Europa ~27% de participación (2025) Evitar sanciones de GDPR, anonimización de datos para cumplimiento de GDPR, preparación para DORA
Asia-Pacífico 14.22% CAGR (2026–2035) DPDP Act, reglas de datos transfronterizos, expansión de la banca digital
América del Sur USD 0.07 Mil millones (2025) Aplicación de LGPD, gobernanza de datos fintech
Medio Oriente y África 12.15% CAGR (2026–2035) Cumplimiento de PDPL, programas de datos de ciudades inteligentes, digitalización de petróleo y gas
Total USD 1.24 Mil millones (2025) —

El Mercado de Enmascaramiento de Datos exhibe una estructura regional concentrada, con América del Norte y Europa controlando conjuntamente aproximadamente el 60% de los ingresos globales. La rápida modernización regulatoria de Asia-Pacífico está reconfigurando el mapa competitivo, mientras que América del Sur y el Medio Oriente & África presentan corredores en etapas tempranas pero de alto potencial para el enmascaramiento de bases de datos en entornos no productivos y la adopción de tokenización para la protección de datos PII.

América del Norte

País Métrica Clave Motor Clave
EE. UU. ~78% de la participación regional Impulso del proyecto de ley de privacidad federal, madurez de la nube empresarial
Canadá 12.88% CAGR (2026–2035) Modernización de PIPEDA, mandatos de enmascaramiento en el sector financiero
México USD 0.02 Mil millones (2025) Disposiciones de protección de datos de la Ley Fintech

Los EE. UU. siguen siendo el mercado nacional más grande para el Mercado de Enmascaramiento de Datos, donde un mosaico de leyes de privacidad estatales —que ahora abarca 18 jurisdicciones— obliga a las empresas multinacionales a implementar técnicas estandarizadas de ofuscación de datos sensibles en todos los entornos de datos [2]. Los bancos canadienses están invirtiendo fuertemente en enmascaramiento de datos estático y dinámico para entornos de prueba tras las actualizaciones de las pautas de riesgo tecnológico de OSFI emitidas en el segundo trimestre de 2024 [5].

Europa

País Métrica Clave Motor Clave
Alemania ~22% de la participación regional Gobernanza de datos de la Industria 4.0, supervisión de BaFin
Reino Unido 13.45% CAGR (2026–2035) Aplicación del GDPR del Reino Unido post-Brexit, reglas de datos de la FCA
Francia USD 0.05 Mil millones (2025) Acciones de aplicación de la CNIL, digitalización de la atención médica
Italia ~9% de la participación regional Modernización del cumplimiento en el sector bancario
España 12.78% CAGR (2026–2035) Impulso de la administración digital, adopción de la nube por pymes
Países Nórdicos USD 0.03 Mil millones (2025) Marcos de banca abierta, infraestructura digital avanzada
Rusia ~4% de la participación regional Ley Federal No. 152-FZ sobre Datos Personales
Resto de Europa 12.50% CAGR (2026–2035) Armonización regulatoria a nivel de la UE

Las multas acumulativas de GDPR superaron los 4.5 mil millones de euros a finales de 2024, manteniendo la inversión en anonimización de datos para el cumplimiento de GDPR en la parte superior de las agendas de los CISO en todo el continente [2]. La base industrial de Alemania está aplicando enmascaramiento de bases de datos para entornos no productivos a plataformas de análisis de IoT y manufactura como parte de programas más amplios de transformación digital de la Industria 4.0.

Asia-Pacífico

País Métrica Clave Motor Clave
China ~31% de la participación regional Aplicación de PIPL, programas de datos de empresas estatales
India 15.10% CAGR (2026–2035) DPDP Act 2023, explosión de datos de UPI/fintech
Japón USD 0.05 Mil millones (2025) Enmiendas de APPI, digitalización de la atención médica
Corea del Sur ~14% de la participación regional Aplicación de PIPA, protección de IP de semiconductores
ASEAN 14.55% CAGR (2026–2035) Marcos de datos transfronterizos, licencias de banca digital
Resto de Asia-Pacífico USD 0.02 Mil millones (2025) Legislación de privacidad emergente

Asia-Pacífico es el corredor de más rápido crecimiento en el Mercado de Enmascaramiento de Datos, impulsado por la Ley DPDP de India que exige la tokenización para la protección de datos PII en todos los fiduciarios de datos y la Ley de Protección de Información Personal (PIPL) de China que requiere enmascaramiento localizado para transferencias transfronterizas [5]. El marco de Cláusulas Contractuales Modelo en evolución de ASEAN está creando demanda de técnicas de ofuscación de datos sensibles interoperables entre las instituciones financieras regionales [12].

América del Sur

País Métrica Clave Motor Clave
Brasil ~62% de la participación regional Aplicación de LGPD, regulación de finanzas abiertas
Argentina 13.10% CAGR (2026–2035) Actualización del proyecto de ley de protección de datos personales
Resto de América del Sur USD 0.01 Mil millones (2025) Adopción de cumplimiento en etapas tempranas

La ANPD de Brasil emitió sus primeras sanciones administrativas en 2023, catalizando la demanda de enmascaramiento de datos estático y dinámico para entornos de prueba entre bancos y fintechs brasileñas que operan bajo los requisitos de la Fase 4 de Finanzas Abiertas [5][12].

Medio Oriente y África

País Métrica Clave Motor Clave
Arabia Saudita ~28% de la participación regional Aplicación de PDPL, infraestructura digital de NEOM
EAU 13.05% CAGR (2026–2035) Regulaciones de datos de DIFC/ADGM, programas de datos de ciudades inteligentes
Sudáfrica USD 0.01 Mil millones (2025) Cumplimiento de POPIA, adopción en el sector financiero
Egipto ~8% de la participación regional Estrategia nacional de centros de datos, crecimiento de fintech
Resto de MEA 11.85% CAGR (2026–2035) Marcos regulatorios incipientes

La PDPL de Arabia Saudita, que entró en vigor en septiembre de 2023, desencadenó una ola de adquisiciones de enmascaramiento de bases de datos para entornos no productivos entre entidades gubernamentales e instituciones financieras que participan en programas de digitalización de Visión 2030 [5]. El marco regulatorio dual de los EAU (DIFC y ADGM) está creando una demanda especializada de anonimización de datos para soluciones equivalentes de cumplimiento de GDPR en empresas de zonas francas [12].

Mercado de Enmascaramiento de Datos por Región, 2025-2035

Data Masking Market Segmentation

Por Tipo (Estático vs. Dinámico)

Segmento Métrica Clave Principal Motor de Demanda
Enmascaramiento Estático 53.21% de participación (2025) Pipelines ETL por lotes, preparación para auditorías regulatorias
Enmascaramiento Dinámico 13.68% CAGR (2026–2035) Protección en tiempo real a nivel de aplicación

El Mercado de Enmascaramiento de Datos sigue siendo liderado por el enmascaramiento estático, que actúa como el caballo de batalla para el enmascaramiento de bases de datos en entornos no productivos donde se transforman copias completas de datos de producción antes de ser provisionadas a equipos de desarrollo, QA y análisis. El enmascaramiento dinámico está ganando terreno en aplicaciones orientadas al cliente donde se requiere tokenización en tiempo real para la protección de datos PII sin alterar el almacén de datos subyacente, un patrón particularmente prevalente en interfaces de call center y banca digital de BFSI.

Por Modelo de Despliegue (Nube vs. Local)

Segmento Métrica Clave Principal Motor de Demanda
Local 50.87% de participación (2025) Mandatos de residencia de datos, entornos de mainframe
Nube 13.91% CAGR (2026–2035) Fragmentación de datos en múltiples nubes, plataformas nativas de SaaS

Los despliegues locales mantienen una ligera mayoría dentro del Mercado de Enmascaramiento de Datos, reflejando la postura conservadora de adquisición de entidades de BFSI y gubernamentales. El enmascaramiento basado en la nube es el segmento de más rápido crecimiento a medida que las empresas adoptan técnicas de ofuscación de datos sensibles que se integran de forma nativa con los servicios de datos de AWS, Azure y GCP.

Por Tamaño de Organización

Segmento Métrica Clave Principal Motor de Demanda
Grandes Empresas 63.48% de participación (2025) Complejos patrimonios de datos en múltiples regiones
PYMES 13.82% CAGR (2026–2035) Plataformas de enmascaramiento SaaS, expansión regulatoria

Las grandes empresas dominan el gasto actual, pero las PYMES representan la constitución de más rápido crecimiento en el Mercado de Enmascaramiento de Datos, ya que los modelos de precios basados en el consumo y las plantillas de cumplimiento preconstruidas reducen la barrera de entrada para la anonimización de datos para el cumplimiento del GDPR.

Por Industria de Usuario Final

Segmento Métrica Clave Principal Motor de Demanda
BFSI USD 0.33 Mil millones (2025) PCI-DSS, SOX, mandatos de banca abierta
TI y Telecomunicaciones ~21% de participación (2025) Datos de prueba de DevOps, protección de datos de suscriptores
Salud 14.08% CAGR (2026–2035) Mandatos de interoperabilidad de EHR, HIPAA
Otras Industrias USD 0.18 Mil millones (2025) Manufactura, retail, educación

BFSI sigue siendo el mayor comprador vertical dentro del Mercado de Enmascaramiento de Datos, donde la tokenización para la protección de datos PII es un requisito de cumplimiento para el procesamiento de tarjetas de pago y plataformas de gestión de patrimonio. La salud es el vertical de más rápido crecimiento, impulsado por los mandatos de sistemas de registros de salud electrónicos y el creciente volumen de datos de ensayos clínicos que requieren enmascaramiento de datos estático y dinámico para entornos de prueba.

Por Entorno de Datos

Segmento Métrica Clave Principal Motor de Demanda
Datos Estructurados 48.62% de participación (2025) Enmascaramiento de RDBMS, almacén de datos
Datos Semi-Estructurados y No Estructurados 14.55% CAGR (2026–2035) Enmascaramiento de documentos basado en NLP, redacción de imágenes

El enmascaramiento de datos estructurados sigue siendo el caso de uso central, pero los datos no estructurados — correos electrónicos, PDFs, registros de chat, imágenes médicas — son la frontera emergente para técnicas de ofuscación de datos sensibles dentro del Mercado de Enmascaramiento de Datos [11].

Comparación Competitiva

El mercado de enmascaramiento de datos exhibe una concentración media, con los cinco principales proveedores controlando colectivamente un estimado del 38–45% de la participación de ingresos. El panorama competitivo combina a los incumbentes establecidos en gestión de datos (IBM, Oracle, Informatica) con especialistas en enmascaramiento y nuevos retadores nativos de la nube. La actividad de fusiones y adquisiciones se está acelerando a medida que los proveedores más grandes buscan llenar vacíos de productos en datos sintéticos, enmascaramiento de datos no estructurados e integraciones de computación confidencial.

Compañía Rango Est. de Participación de Ingresos Ofertas Clave Posicionamiento Estratégico
IBM Corporation ~8–11% InfoSphere Optim, Guardium Protección de Datos Enmascaramiento de nivel empresarial integrado con una suite de seguridad más amplia
Oracle Corporation ~7–10% Enmascaramiento y Subconjunto de Datos de Oracle Integración profunda con el ecosistema de bases de datos de Oracle
Informatica Inc. ~6–9% Enmascaramiento de Datos Persistente, Enmascaramiento de Datos Dinámico Plataforma de gobernanza de datos nativa de la nube y potenciada por IA
Delphix (Perforce) ~5–8% Plataforma de Datos Delphix Gestión y enmascaramiento de datos de prueba centrados en DevOps
Broadcom (CA Technologies) ~4–7% CA Test Data Manager Enmascaramiento en mainframe y distribuido para grandes empresas
Microsoft Corporation ~4–6% Enmascaramiento de Datos Dinámico de Azure SQL, Purview Enmascaramiento nativo en la nube dentro del stack de datos de Azure
Mentis Inc. ~2–4% Plataforma SensitiveData+ Descubrimiento y enmascaramiento automatizado de PII en datos estructurados/no estructurados
Micro Focus (OpenText) ~3–5% Voltage SecureData Cifrado y tokenización que preserva el formato
K2View ~2–4% Enmascaramiento de Datos K2View Enmascaramiento basado en entidades con arquitectura de tejido de datos en tiempo real
Accutive Data Systems ~1–3% Descubrimiento de Datos Accutive, Enmascaramiento de Datos Enmascaramiento y descubrimiento automatizado enfocado en el mercado medio

Noticias Recientes y Desarrollos

  • IBM (marzo de 2025): Lanzó Guardium AI Data Security, integrando clasificación de campos sensibles impulsada por IA con flujos de trabajo de enmascaramiento Optim, reduciendo el tiempo de implementación en un 40% para clientes empresariales [7].
  • Informatica (enero de 2025): Anunció la disponibilidad general de su módulo de enmascaramiento dinámico de datos impulsado por IA CLAIRE en AWS Marketplace, dirigido a tuberías DevOps nativas de la nube [6].
  • Delphix (octubre de 2024): Completó la adquisición por Perforce Software, consolidando la gestión de datos de prueba y las capacidades de enmascaramiento bajo una plataforma DevOps unificada [18].
  • Oracle (agosto de 2024): Expandió Oracle Data Masking y Subsetting para soportar entornos de bases de datos autónomas, habilitando recomendaciones automáticas de políticas de enmascaramiento.
  • Comisión Europea (junio de 2024): Publicó directrices técnicas bajo DORA que requieren que las instituciones financieras implementen la anonimización de datos para el cumplimiento del GDPR y controles de enmascaramiento para todos los entornos no productivos antes de enero de 2025 [2].
  • Microsoft (abril de 2024): Introdujo políticas de enmascaramiento integradas de Azure Purview, permitiendo la gobernanza centralizada de la tokenización para la protección de datos PII en múltiples entornos de datos en la nube [6].
  • K2View (diciembre de 2023): Recaudó 28 millones de dólares en financiamiento de la Serie C para expandir las capacidades de enmascaramiento basado en entidades y entrar en el sector de la salud [9].
  • India MEITY (septiembre de 2023): Publicó un borrador de reglas bajo la Ley DPDP que exige el enmascaramiento de bases de datos para entornos no productivos que contengan datos de ciudadanos en todas las plataformas digitales gubernamentales [5].

Data Masking Market Report Scope

Parámetro Detalle
Alcance del Mercado Mercado Global de Enmascaramiento de Datos cubriendo tipo, modelo de implementación, tamaño de la organización, industria del usuario final, entorno de datos y geografía
Período de Estudio 2021–2035
CAGR 13.28% (2026–2035)
Tamaño del Mercado (2025) USD 1.24 Mil millones
Tamaño del Mercado (2035) USD 4.48 Mil millones
Segmentos de Más Rápido Crecimiento Enmascaramiento dinámico (por tipo); Nube (por implementación); Salud (por vertical); Asia-Pacífico (por región)
Empresas Perfiladas IBM, Oracle, Informatica, Delphix (Perforce), Broadcom, Microsoft, Mentis, Micro Focus (OpenText), K2View, Accutive Data Systems
Moneda de Valoración USD Mil millones

Preguntas frecuentes

¿Cómo deberían las empresas evaluar el costo total de propiedad (TCO) para una plataforma de enmascaramiento de datos?
El TCO abarca licencias, servicios de implementación (típicamente 1.5–2.5× el costo de la licencia), mantenimiento continuo y capacitación del personal interno durante un horizonte de 3 años . Presupuestar el 15–20% de las tarifas anuales de licencia para actualizaciones de integración y ciclos de parches de cumplimiento.
¿Qué diferencia el cifrado que preserva el formato del enmascaramiento de datos tradicional dentro del Mercado de Enmascaramiento de Datos?
El cifrado que preserva el formato mantiene el tipo de datos, la longitud y la integridad referencial mientras aplica transformaciones criptográficas, lo que lo hace adecuado para sistemas que validan formatos de campo [14]. El enmascaramiento tradicional utiliza sustitución o barajado sin la sobrecarga de cifrado.
¿Cómo aborda el Mercado de Enmascaramiento de Datos el enmascaramiento para tuberías de datos en streaming en tiempo real?
Los motores de enmascaramiento dinámico ahora se integran con Apache Kafka y plataformas de streaming de eventos para aplicar tokenización a nivel de campo para la protección de datos PII en la ingestión [13]. La sobrecarga de latencia típicamente añade 2–5 milisegundos por transformación de registro.
¿Qué papel juega el dato sintético junto al enmascaramiento en el Mercado de Enmascaramiento de Datos?
Los generadores de datos sintéticos crean registros estadísticamente representativos sin derivar de PII real, complementando el enmascaramiento para cargas de trabajo de entrenamiento de IA/ML [9]. Las implementaciones combinadas reducen el riesgo de re-identificación por debajo del umbral del 0.09% recomendado por NIST.
¿Cómo miden las organizaciones la efectividad del enmascaramiento para auditorías regulatorias?
Los programas de enmascaramiento listos para auditoría rastrean puntajes de riesgo de re-identificación, métricas de utilidad de datos y proporciones de cobertura de políticas en todos los entornos [2]. Los reguladores esperan evidencia documentada de que las técnicas de ofuscación de datos sensibles se aplicaron de manera consistente antes del acceso.
¿Qué desafíos surgen al aplicar enmascaramiento en entornos multi-nube dentro del Mercado de Enmascaramiento de Datos?
La deriva de esquema, los controles de acceso inconsistentes y los estándares de cifrado heterogéneos entre proveedores de nube crean brechas de sincronización de políticas [6]. Las empresas típicamente implementan una capa de orquestación de enmascaramiento centralizada para hacer cumplir reglas uniformes.
¿Cómo se espera que la computación confidencial transforme el Mercado de Enmascaramiento de Datos hasta 2035?
Los entornos de ejecución confiables basados en hardware protegen los datos durante el procesamiento, reduciendo la dependencia del enmascaramiento previo al cálculo para cargas de trabajo analíticas . Los proveedores de enmascaramiento están pivotando hacia modelos híbridos que combinan protección basada en TEE y protección basada en software.
Autor
Autor Author Profile Ankit Gupta LinkedIn Team Lead - Research
Ankit Gupta is a seasoned market intelligence and strategic research professional with over six plus years of experience in the ICT and Semiconductor industries. With academic roots in Telecom, Marketing, and Electronics, he blends technical insight with business strategy. Ankit has led 200+ projects, including work for Fortune 500 clients like Microsoft and Rio Tinto, covering market sizing, tech forecasting, and go-to-market strategies. Known for bridging engineering and enterprise decision-making, his insights support growth, innovation, and investment planning across diverse technology markets.
Coautor Co-Author Profile Aarti Dhapte LinkedIn AVP - Research
A consulting professional focused on helping businesses navigate complex markets through structured research and strategic insights. I partner with clients to solve high-impact business problems across market entry strategy, competitive intelligence, and opportunity assessment. Over the course of my experience, I have led and contributed to 100+ market research and consulting engagements, delivering insights across multiple industries and geographies, and supporting strategic decisions linked to $500M+ market opportunities. My core expertise lies in building robust market sizing, forecasting, and commercial models (top-down and bottom-up), alongside deep-dive competitive and industry analysis. I have played a key role in shaping go-to-market strategies, investment cases, and growth roadmaps, enabling clients to make confident, data-backed decisions in dynamic markets.

Research Approach


Secondary Research

The secondary research process involved comprehensive analysis of regulatory frameworks, cybersecurity databases, enterprise technology publications, and authoritative data protection agencies. Key sources included the National Institute of Standards and Technology (NIST), European Union Agency for Cybersecurity (ENISA), International Organization for Standardization (ISO/IEC 27001), Cloud Security Alliance (CSA), International Association of Privacy Professionals (IAPP), European Data Protection Board (EDPB), U.S. Federal Trade Commission (FTC) Privacy and Data Security Division, Information Commissioner's Office (UK ICO), National Cyber Security Centre (NCSC), Asia-Pacific Economic Cooperation (APEC) Privacy Framework, and national cybersecurity agencies from key markets (CISA, ANSSI, BSI).

These sources were employed to gather compliance statistics, regulatory enforcement data, breach incident reports, adoption trends, and competitive landscape analysis for managed security services, static data masking, and dynamic data masking.


Primary Research

Qualitative and quantitative insights were obtained by interviewing supply-side and demand-side stakeholders during the primary research process. CEOs, CTOs, VPs of Product Development, Chief Information Security Officers (CISOs), and Heads of Data Governance from data concealing solution vendors, cloud service providers, and cybersecurity OEMs comprised supply-side sources. Demand-side sources of information included Chief Information Officers (CIOs), Data Protection Officers (DPOs), Enterprise Architects, IT Security Directors, and Compliance Leads from healthcare organizations, retail enterprises, government agencies, and BFSI institutions. Market segmentation was validated across software and services components, cloud deployment timelines were confirmed, and insights on enterprise adoption patterns, pricing models, and integration dynamics with existing data governance frameworks were gathered using primary research.

Primary Respondent Breakdown:

By Designation: C-level Primaries (32%), Director Level (30%), Others (38%)

By Region: North America (38%), Europe (25%), Asia-Pacific (28%), Rest of World (9%)


Market Size Estimation

Revenue mapping and deployment volume analysis were implemented to determine global market valuation. The methodology comprised the following:

Identification of over 50 key vendors in North America, Europe, Asia-Pacific, and Latin America who specialize in data masking software and related services

Product mapping for professional services, managed security services, static data masking, and dynamic data masking

Examination of annual revenues that are specific to data privacy and obfuscation solution portfolios, as reported and modeled

In 2024, the coverage of vendors will account for 75-80% of the global market share.

Derive segment-specific valuations across business functions, including HR, sales & marketing, and legal finance operations, through extrapolation using bottom-up (enterprise deployment volume × Average Selling Price by organization size and region) and top-down (vendor revenue validation against total IT security spending) approaches.

Descargar muestra gratis

Complete el formulario a continuación para recibir una muestra gratuita de este informe

Download PDF ×

We do not share your information with anyone. However, we may send you emails based on your report interest from time to time. You may contact us at any time to opt-out.



















